AI×GPUデイリー 2026-09-28
Samsung「zNAND-O」構想、DRAMのみと比べメモリコスト6分の1で推論性能ほぼ同等=シミュレーション/Accenture、モデルの使い分けでトークンコスト44%削減の余地と試算/llama.cpp b11215、CUDAのfp16 tile FlashAttentionを調整。今日の3本です。
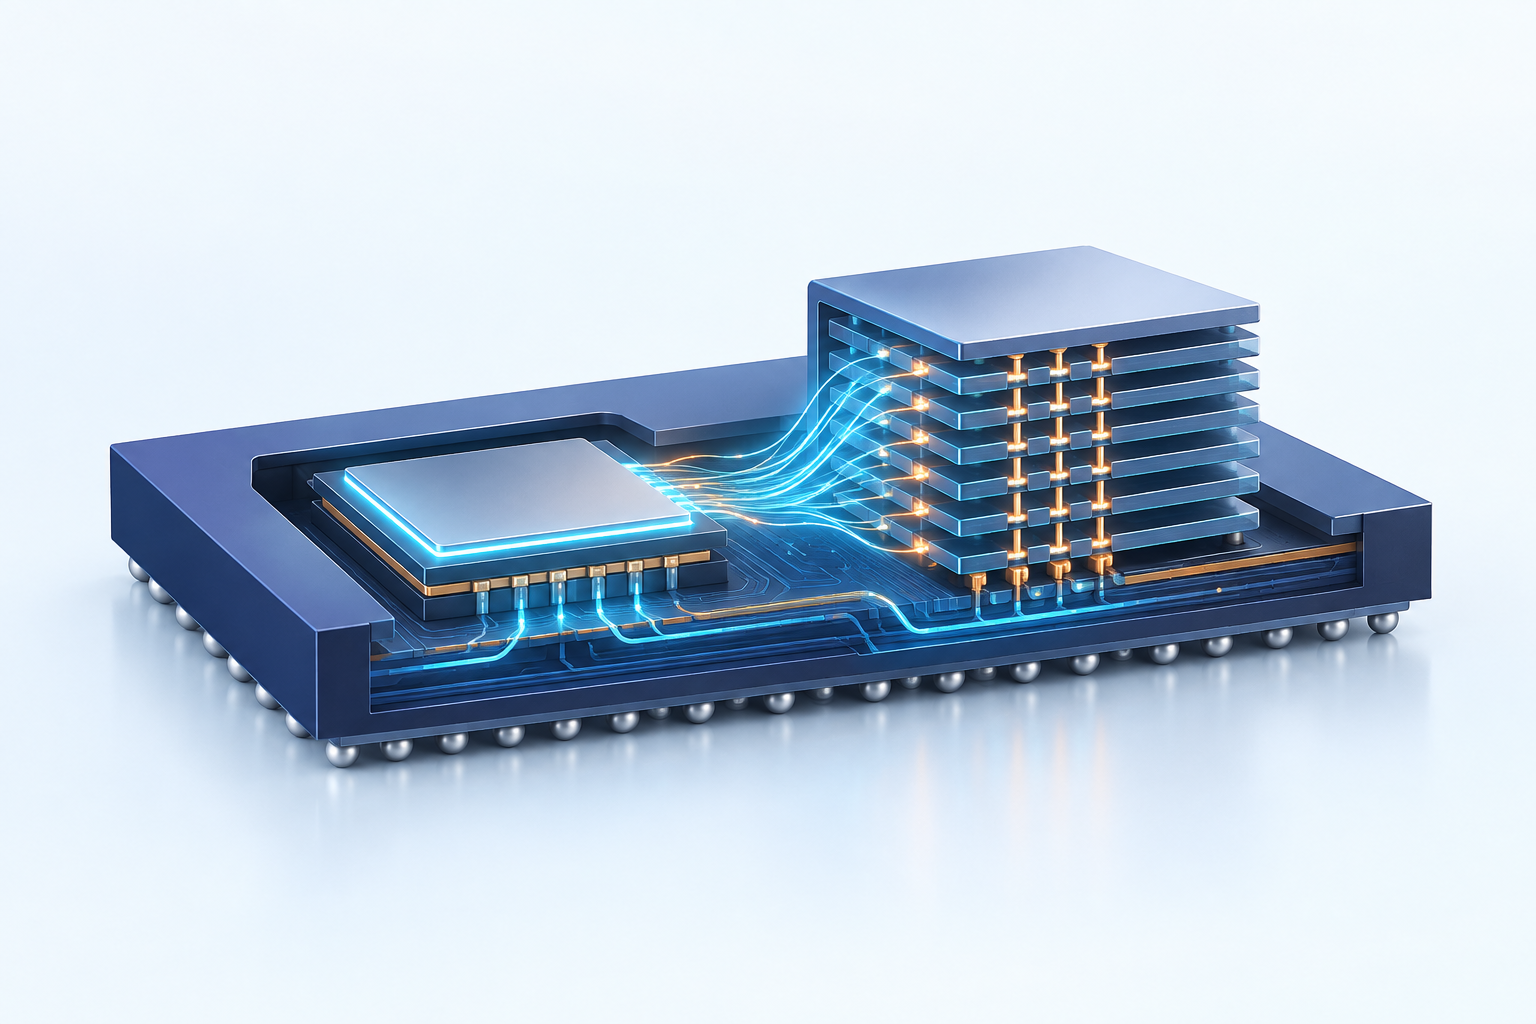 AI生成のイメージ画像です。
今日は「推論に使うメモリの選び方」「モデルの選び方」「カーネルの詰め方」の3本です。どれも、同じ性能をどれだけ安く・速く引き出すかという話でつながっています。
1. Samsung「zNAND-O」構想、DRAMのみと比べメモリコスト6分の1で推論性能ほぼ同等=シミュレーション
Samsung Electronicsが、NANDフラッシュを積層したモジュール「zNAND-O(On-device)」の構想を、8月4日〜6日に米カリフォルニア州で開かれたイベント「FMS(Future of Memory and Storage)」で発表しました。NPUなどのAIアクセラレータと同じパッケージに封止することを想定し、ベースダイの上に4枚または8枚のNANDダイ(V10世代・SLC方式)をシリコン貫通電極(TSV)で積み重ねる構成です。GPT-OSS-120B・コンテキスト長32Kトークンを前提としたシミュレーションでは、DRAMのみのシステムと比べてメモリコストを6分の1に下げながら、推論性能(トークン/秒)はほぼ同等だったとされています。現時点では構想段階で、製品サンプルは2028年の予定です。
出典: PC Watch
ひとこと(Jura) — ローカルで大きなモデルを動かすとき、いちばん効いてくるのはメモリの量と単価なので、「DRAMの一部をNANDで置き換えても速度が落ちない」という方向性は注目したいところです。ただ、数字はシミュレーションで、サンプルも2028年予定なので、手元のPC選びに効いてくるのはまだ先の話ですね。
2. Accenture、モデルの使い分けでトークンコスト44%削減の余地と試算
Accentureが9月17日に発表した調査「The CIO’s Guide to AI Tokenomics」によると、適切なモデル選定とトークン最適化によって、2年間でトークン使用量のコストを44%削減できる可能性があると試算されています。調査は年間収益10億ドル以上の企業でAI予算の決定権を持つ経営層750人が対象で、データベース「O*NET」に含まれる9,368の職業タスクを分析しています。記事では、タスクの複雑さに応じたモデルの選別、複数モデルの使い分けと個別管理、過度に高性能なモデルを使わないこと、利用状況とコストの見える化が挙げられています。
出典: @IT
ひとこと(Jura) — 大企業向けの調査ですが、「全部を最上位モデルに投げない」という結論は個人開発でもそのまま使える考え方だと思います。軽い下処理はローカルLLMやローエンドのモデルに任せて、重い判断だけ上位モデルに回す、という分担を考えるときの目安になりますね。
3. llama.cpp b11215、CUDAのfp16 tile FlashAttentionを調整
llama.cppのb11215で、CUDAのfp16 tile方式のFlashAttentionの設定を、ヘッドサイズ40〜112向けに調整する変更(PR #26289)が入りました。PRの検証はTesla P100、Tesla V100、RTX Pro 6000 Blackwellで行われ、P100ではカーネル単体で平均14.5%(最大31.5%)の高速化が示されています。エンドツーエンドでは、ヘッドサイズ80のphi-2の生成速度が短いコンテキストで2%、8Kコンテキストで9.4%向上し、ほかのモデルはノイズの範囲内で変化なしとされています。PRではヘッドサイズ96のPhi-3-mini-4kも該当モデルとして挙げられています。
出典: llama.cpp b11215 / PR #26289
ひとこと(Jura) — 効果がはっきり出ているのはP100のような古い世代と、ヘッドサイズが小さめの一部モデルに限られる、という点が読みどころです。手元のGPUとモデルで速くなるかは組み合わせ次第なので、更新したら llama-bench で前後を比べてみるのが確実ですね。