LM StudioとOllama、同じGPU・同じモデルファイルなら速さはどれだけ違うか — RTX 2070 SUPERで実測
RTX 2070 SUPER(VRAM 8GB)で、OllamaとLM Studioに完全に同じGGUF(qwen3 8B Q4_K_M)を読ませて5回ずつ実測。Ollama 67.54、LM Studio 64.58トークン/秒で差は約4.4%。測り方と録画も載せる。
同じGPU・同じモデルファイルで比べると、Ollamaは67.54トークン/秒、LM Studioは64.58トークン/秒。差は約4.4%だった。
ローカルLLMの実行ツールは、OllamaとLM Studioの2つが定番だ。どちらが速いかという話はよく出るが、比べる側のモデルや量子化がそろっていないと、ツールの差なのかモデルの差なのか分からない。
そこで手元のRTX 2070 SUPER機(i7-9700K/メモリ16GB)で、バイト単位で同じモデルファイルを2つのツールに読ませて測った。1台・1条件での測定で、環境が違えば結果は変わる。
測った条件。同じGGUFを2つのツールに読ませる
Ollamaが使っているqwen3 8B(Q4_K_M)のモデル本体はGGUFファイルだ。これをそのままコピーしてLM Studioのモデル置き場に置いた。コピー後のSHA-256は、Ollamaが管理するファイルのダイジェスト(a3de86cd1c13…)と一致した。重みは完全に同じだ。
現場でいえば、同じ資材を同じ搬入口から入れて、使う重機だけを替えた形になる。
| 項目 | 内容 |
|---|---|
| 測定日 | 2026年10月20日 |
| 機材 | i7-9700K / RTX 2070 SUPER(VRAM 8GB)/ DDR4 16GB / Windows 11 Home |
| ドライバー | NVIDIA 617.14 |
| Ollama | 0.34.4 |
| LM Studio | ヘッドレス版 llmster 0.0.25-1、エンジン llama.cpp CUDA版 2.41.0 |
| モデル | qwen3 8B Q4_K_M(両ツールで同一のGGUF) |
| 生成設定 | temperature 0・seed 42・最大256トークン・コンテキスト4096・全層GPU |
| 思考モード | 両方オフ(Ollamaは think=false、LM Studioはプロンプト末尾に /no_think) |
| 回数 | 暖機1回のあと各5回。中央値を採用 |
| 速さの取り方 | 各ツールが返す自己計測値 |
LM Studioは、公式のヘッドレス版の手順(PowerShellで irm https://lmstudio.ai/install.ps1 | iex)で入れた(出典: LM Studio Headless)。読み込みは lms load に --gpu max(全部GPUに載せる)と --context-length 4096 を付けた(出典: LM Studio lms load)。
GPUは1枚しかないので、1つずつ起動して測った。測らない側のツールは止め、VRAMが空いたのを確かめてから始めている。
速さの取り方はツールごとに違う。Ollamaは eval_count(出力トークン数)÷ eval_duration(生成時間)で計算した(出典: Ollama API generate)。LM Studioは /api/v0/chat/completions が返す stats の tokens_per_second をそのまま使った(出典: LM Studio REST API)。
思考モードの切り替えは、Qwen3のモデルカードに「ユーザーのプロンプトかシステムメッセージに /think と /no_think を付けて切り替えられる」とある(出典: Qwen3-8B モデルカード)。temperature 0は再現性のための設定で、モデルカードの推奨値(非思考モードで0.7)とは違う。
結果。差は約4.4%、ばらつきよりは大きい
5回の数値をまとめる。
| ツール | 中央値 | 5回の幅 | 生成トークン数 |
|---|---|---|---|
| Ollama 0.34.4 | 67.54 tok/s | 67.39〜67.79 | 126 |
| LM Studio(llmster 0.0.25-1) | 64.58 tok/s | 64.29〜64.93 | 125 |
Ollamaのほうが中央値で約3トークン/秒速かった。割合にすると約4.4%だ。
各ツールの5回のばらつきは0.6トークン/秒以内に収まっている。差の3トークン/秒はそれより大きいので、測った範囲では「たまたま」ではない差と読める。
一方で、出力の中身はほぼ同じだった。どちらも256トークンに届く前に自然に書き終え、VRAMの役割を初心者向けに説明する同じ流れの文章になった。
最初の1文字と、読み込みの時間
文字が出始めるまでの時間も、Mac側からストリーミングで受けて測った。SSHのトンネルを通した壁時計なので、あくまで補助の値だ。
| ツール | 最初の文字が届くまで(5回) |
|---|---|
| Ollama | 0.044 / 0.027 / 0.045 / 0.026 / 0.028秒 |
| LM Studio | 0.100 / 0.099 / 0.132 / 0.097 / 0.120秒 |
どちらも0.15秒未満だった。プロンプトのトークン数がOllama 51、LM Studio 47と違うのは、チャットの書式(テンプレート)の扱いがツールごとに違うためだ。
モデルの読み込みは、Ollamaが13.9秒(APIの load_duration)、LM Studioが29.1秒(lms load コマンド全体をSSH越しに計った時間)だった。測り方がそろっていないので、この2つは単純に比べられない。
読み込んだあとのVRAM使用量は、nvidia-smiでOllama 6,294MiB、LM Studio 6,250MiBだった。8GBの枠には、どちらも余裕を残して収まっている。GPUの使用状況の読み方はnvidia-smiの読み方にまとめてある。
録画で見ると、差はほとんど見分けられない
同じ質問をそれぞれのツールに送り、ブラウザに文字が流れる様子を実時間で録った。
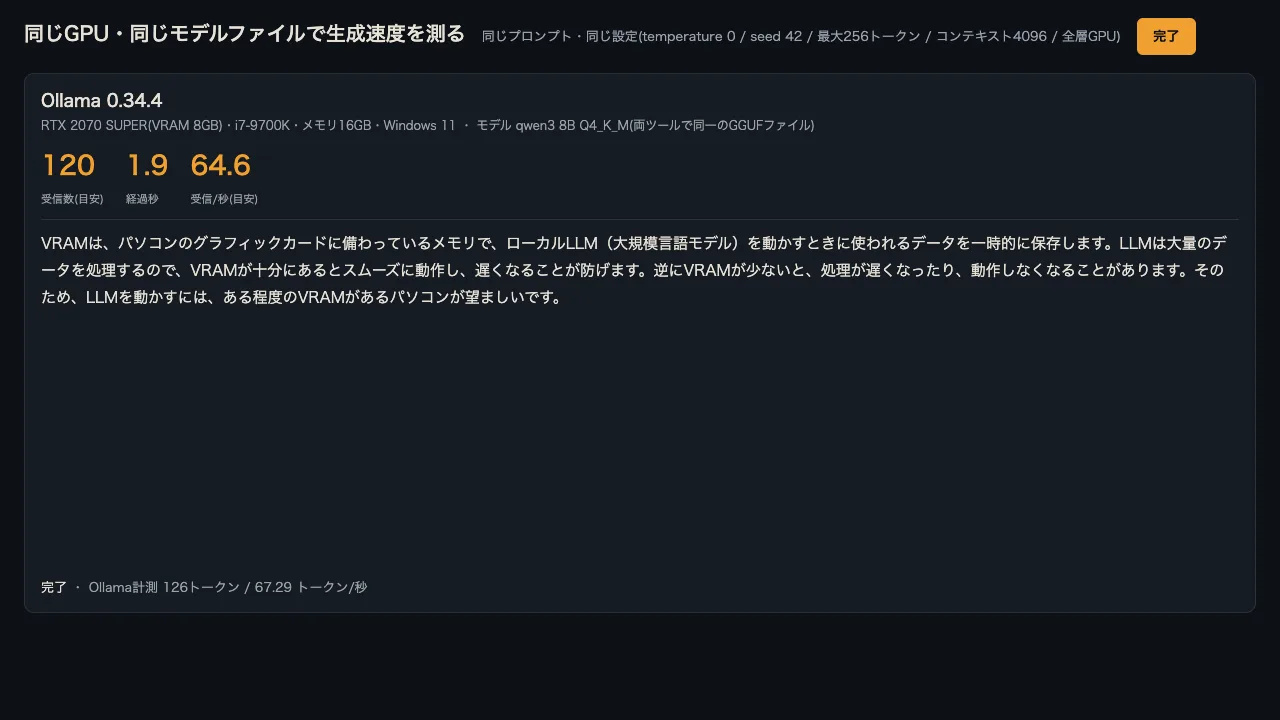
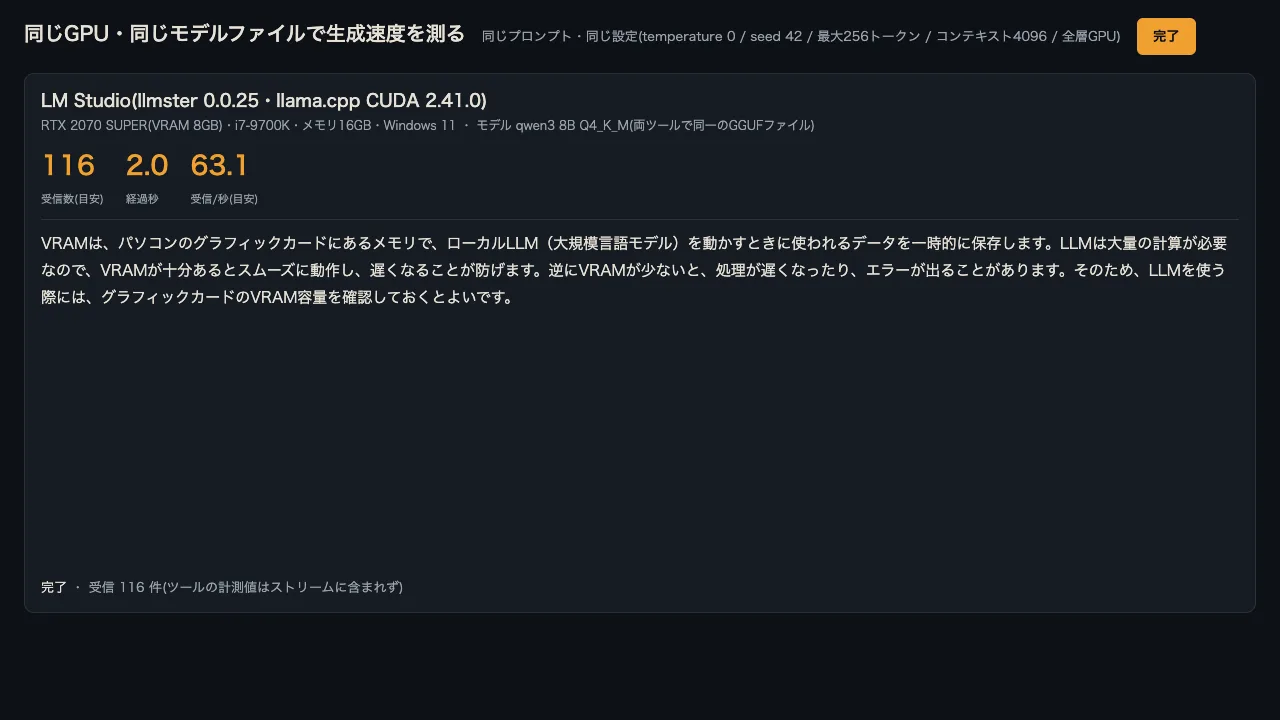
300字ほどの回答で、出終わるまでの差は0.1秒ほどだった。並べて見ても、目で差を見分けるのは難しい。
4%の差より先に見ておくこと
測った範囲で言えば、8Bクラスが全部VRAMに載る条件では、ツールを替えても速さは5%も変わらなかった。
逆に、速さを1桁変えたのはVRAMからあふれたかどうかだ。同じ2070 SUPERでも、qwen3 14Bは4割近くがあふれて7.6トークン/秒まで落ちた(VRAMからあふれたときの実測)。
段取り八分でいえば、ツール選びより先に「載せたいモデルが搬入口に入るか」を決めるほうが効く。
LM Studioの公式要件は、x64ならAVX2対応のCPUが必須で、メモリは16GB以上、専用VRAMは4GB以上が推奨とされる(出典: LM Studio System Requirements)。Ollamaの入れ方はOllama導入手順、VRAM別に載るモデルの目安はローカルLLMのPCスペック早見表にある。
なお、LM Studioは読み込み時に「同時に受ける数(PARALLEL)」が4になっていた。今回は1件ずつ送ったので、この設定が速さにどう効くかは確かめていない。
まとめ。ツールの差は約4%、枠の差は1桁
測った範囲で言えるのは次の3つだ。
- 同じGGUF・同じGPUで、Ollamaは67.54、LM Studioは64.58トークン/秒(5回の中央値)。差は約4.4%
- 5回のばらつきは各0.6トークン/秒以内で、差はそれより大きい
- 最初の文字はどちらも0.15秒未満。300字の回答を出し終えるまでの差は0.1秒ほど
速さを大きく左右するのはツールではなく、モデルがVRAMに収まるかだ。枠を広げる前提で選ぶなら、今週のセール機をVRAM基準で仕分けた表と二刀流ランキングを置いておく。最強の1台より、載せたいモデルが丸ごと入る枠、この1点を外さない1台だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機・1台・2026年10月20日)での測定に基づく解説です。1モデル・1条件・各5回の測定で、ドライバー・各ツールの版・常駐アプリ・設定(コンテキスト長・同時処理数)で結果は変わります。読み込み時間は2つのツールで測り方が違います。最新の仕様は各公式ドキュメントをご確認ください。
出典
- LM Studio Headless(ヘッドレス版 llmster のWindowsでの導入コマンド・lms daemon up・lms server start): https://lmstudio.ai/docs/developer/core/headless
- LM Studio lms load(–gpu の値 0〜1・off・max、–context-length、–estimate-only): https://lmstudio.ai/docs/cli/local-models/load
- LM Studio REST API(/api/v0/chat/completions の stats.tokens_per_second・time_to_first_token): https://lmstudio.ai/docs/developer/rest/endpoints
- LM Studio System Requirements(AVX2必須・メモリ16GB推奨・専用VRAM 4GB推奨): https://lmstudio.ai/docs/app/system-requirements
- Ollama API generate(eval_count・eval_duration・load_duration・prompt_eval_count・think): https://docs.ollama.com/api/generate
- Ollama FAQ(ollama psの表示・モデルの保存場所): https://docs.ollama.com/faq
- Ollama qwen3 タグ一覧(8b-q4_K_M): https://ollama.com/library/qwen3/tags
- Qwen3-8B モデルカード(8.2Bパラメータ・/think と /no_think の切り替え・非思考モードの推奨temperature 0.7): https://huggingface.co/Qwen/Qwen3-8B