OllamaのモデルがVRAMからあふれると何が起きるか — RTX 2070 SUPER 8GBでqwen3 8B/14B/32Bを実測
RTX 2070 SUPER(VRAM 8GB)のOllamaでqwen3の8B・14B・32Bを実測。全部載る8Bは66.82トークン/秒、37%があふれた14Bは7.6、32Bは0.02。ollama psの読み方とOLLAMA_MODELSの公式手順も整理する。
VRAMに収まる8Bは66.82トークン/秒、4割近くがあふれた14Bは7.6トークン/秒。モデルが2倍弱になっただけで、速さは約9分の1に落ちた。
Ollamaは、モデルがVRAMに入りきらなくても止まらない。残りをメインメモリ側に置いて動き続ける。
問題は「動く」と「使える速さ」が別物だということだ。手元のRTX 2070 SUPER機(i7-9700K/メモリ16GB)で、qwen3の8B・14B・32Bを測った。1台・1条件での測定で、環境が違えば結果は変わる。
測った条件。8GBの枠に、5.6GB・10GB・22GBを入れる
RTX 2070 SUPERのメモリは公称8GB GDDR6、256-bit、アーキテクチャはTuringだ(出典: NVIDIA GeForce RTX 20シリーズ比較)。
Ollamaのライブラリでは、qwen3の 8b-q4_K_M が5.2GB、14b-q4_K_M が9.3GB、32b-q4_K_M が20GBと表示されている(出典: Ollama qwen3 タグ一覧)。
現場でいえば、搬入口が8GBしかない現場に、小・中・大の3種類の資材を入れてみた形だ。
| 項目 | 内容 |
|---|---|
| 測定日 | 2026年9月28日 |
| 機材 | i7-9700K / RTX 2070 SUPER(VRAM 8GB)/ DDR4 16GB / Windows 11 Home |
| ソフト | Ollama 0.34.4 / NVIDIAドライバー 617.14 |
| モデル | qwen3:8b-q4_K_M / qwen3:14b-q4_K_M / qwen3:32b-q4_K_M |
| 生成設定 | temperature 0・seed 42・num_predict 256・num_ctx 4096・思考モードなし。プロンプトは全モデル同じ |
| 回数 | 読み込み込みの1回目のあと、3回測った中央値。32Bだけ1回目が120秒を超えたため追加なし |
| 32Bの例外 | num_predict 32(256では30分を超えて終わらなかったため、短い生成で測った) |
| 速さの取り方 | Ollamaが返す eval_count(出力トークン数)÷ eval_duration(生成時間) |
eval_countは「生成した出力トークン数」、eval_durationは「トークン生成にかかった時間(ナノ秒)」と公式APIに書かれている(出典: Ollama API generate)。
常駐アプリは普段どおり残したまま測っている。
結果。あふれた瞬間に、速さが1桁落ちる
数値をそのまま並べる。
| モデル | 読み込み時のsize | VRAM側 | 生成速度(中央値) | 1回目の読み込み |
|---|---|---|---|---|
| qwen3:8b-q4_K_M | 5.58GB | 5.58GB(100%) | 66.82 tok/s | 14.24秒 |
| qwen3:14b-q4_K_M | 10.15GB | 6.35GB(63%) | 7.6 tok/s | 25.16秒 |
| qwen3:32b-q4_K_M | 21.56GB | 6.35GB(29%) | 0.02 tok/s | 83.89秒 |
8Bは全部VRAMに載り、66.82トークン/秒だった。
14Bはモデルが8Bの約1.8倍だが、速さは約9分の1の7.6トークン/秒になった。VRAM側は6.35GBで止まり、残りの約37%がVRAMの外に置かれた。
32Bは71%があふれた。32トークンを書くのに、読み込みを含めて1,818.03秒、約30分かかった。
「VRAMを少し超えたぶん少し遅くなる」のではない。超えた時点で段が1つ落ちる、というのが測った範囲での見え方だ。
そのときGPUとメモリはどうなっていたか
読み込み中に、nvidia-smiとWindowsのメモリ状況も記録した。
| モデル | VRAM使用(nvidia-smi) | GPU使用率 | メモリ空き(16,305MiB中) | ページファイル使用 |
|---|---|---|---|---|
| 8B | 5,961MiB | 96% | 11,401MiB | 1,625MiB |
| 14B | 6,697MiB | 13% | 8,057MiB | 1,592MiB |
| 32B | 6,697MiB | 0% | 15MiB | 3,939MiB |
8BではGPU使用率96%だった。14Bでは13%まで下がっている。
VRAMの外に置いた分の計算を待つ間、GPUが手待ちになっていると読める。ただしこれは記録した数値からの推測で、内部の処理までは測っていない。
32Bでは、メインメモリの空きが15MiBまで減り、ページファイル(ディスク上の仮のメモリ)の使用が増えた。VRAM 8GBとメモリ16GBを足しても、OSや常駐アプリの分を引くと22GBの資材は置ききれない。
8Bと14Bを同じ質問・同じ設定で、Mac miniと同時に走らせた録画がある。左が2070 SUPERだ。
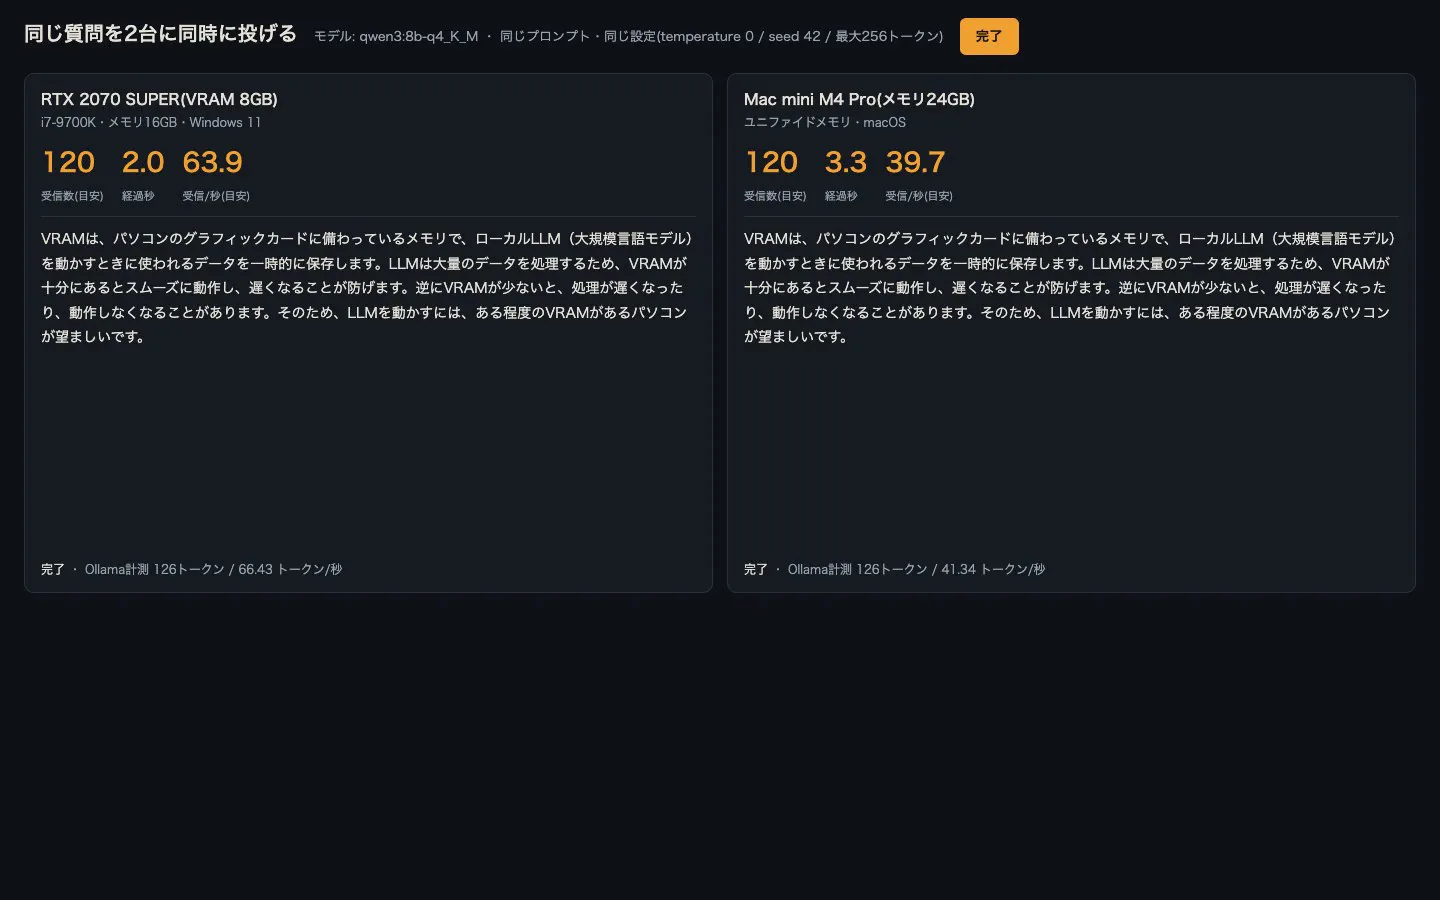
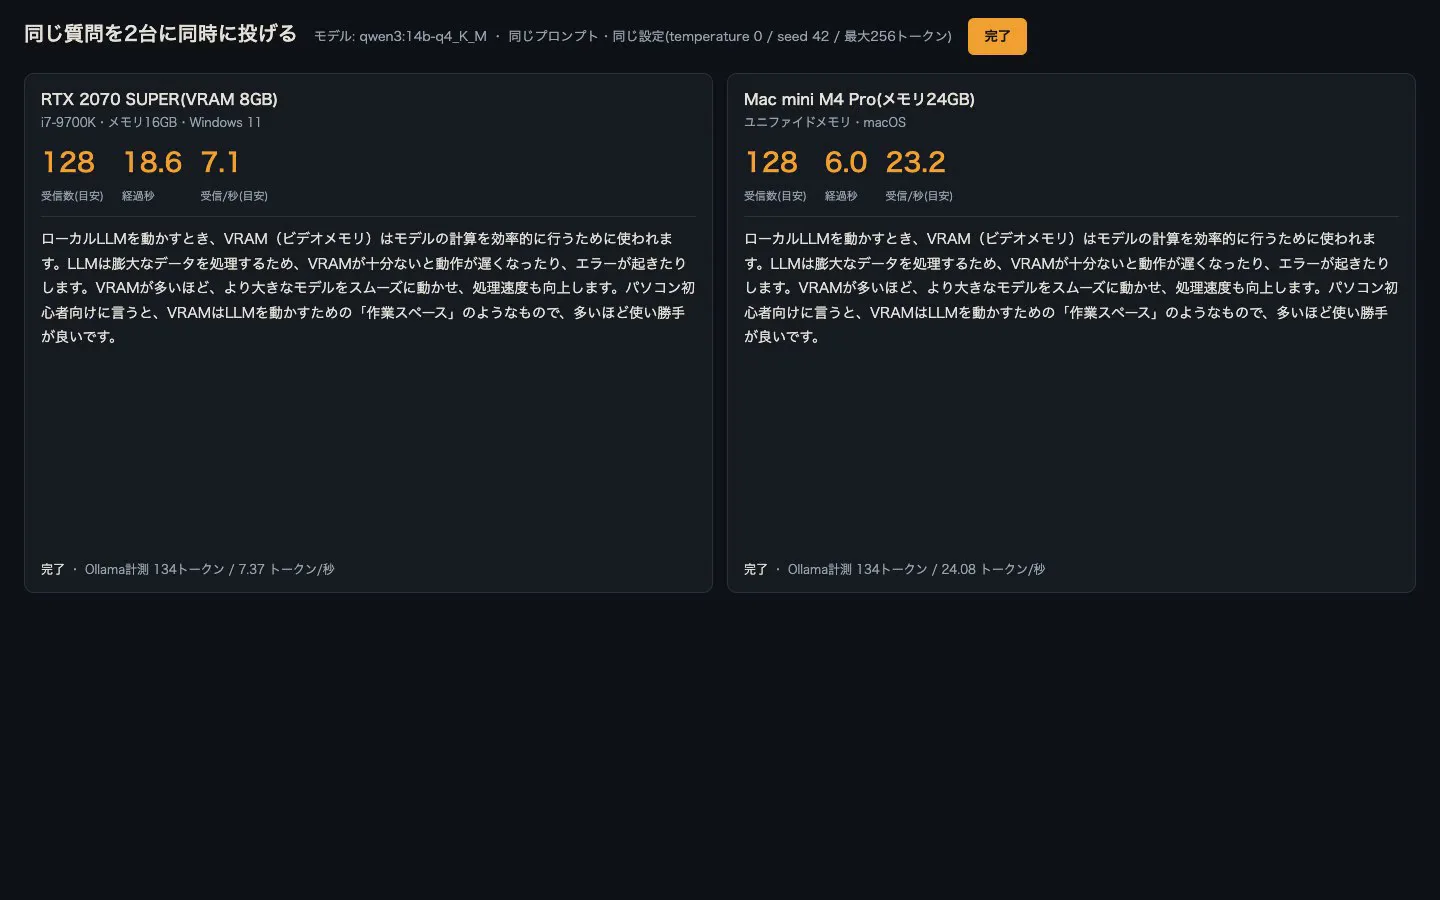
Mac側の結果は、別の記事で詳しく扱う。
あふれているかは ollama ps で分かる
自分のモデルがVRAMに収まっているかは、ollama ps で確かめられる。
公式FAQによると、PROCESSOR欄が「100% GPU」なら全部GPU、「100% CPU」ならメインメモリ、「48%/52% CPU/GPU」のような表示なら両方に分かれている(出典: Ollama FAQ)。
APIの /api/ps なら、size(モデルの大きさ)とsize_vram(VRAM使用量)がバイトで返る(出典: Ollama API ps)。今回の14Bの記録はこうだった。
   "size": 10153539663,
   ...
   "size_vram": 6354097929,
   "context_length": 4096
6,354,097,929 ÷ 10,153,539,663 で約63%。これが表のVRAM側の割合だ。
ちなみにOllamaの既定のコンテキスト長は4096トークンで、並列リクエストを増やすと必要なメモリは OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH に比例して増える、と公式FAQにある(出典: Ollama FAQ)。今回はnum_ctx 4096で固定しており、コンテキスト長を変えた比較はしていない。
走らせる前に ollama ps で「100% GPU」かを見る。これだけで、遅さの原因の当たりがつく。
OLLAMA_MODELSで、モデル置き場をCドライブ以外へ
あふれる・あふれないの話とは別に、モデルを何本も試すとディスクが先に埋まる。今回の3本だけでも、ライブラリ表示で5.2GB+9.3GB+20GBだ。
Windowsでの既定の置き場は C:\Users\%username%\.ollama\models で、環境変数 OLLAMA_MODELS で変えられる(出典: Ollama FAQ)。公式の手順は次のとおりだ(出典: Ollama FAQ、Ollama Windows)。
- タスクバーのOllamaを終了する
- 設定(Windows 11)またはコントロールパネルで「環境変数」を検索する
- 「アカウントの環境変数を編集」を開き、
OLLAMA_MODELSを新規作成して置き場のフォルダを指定する - OK/適用で保存し、スタートメニューからOllamaを起動し直す
公式のWindows向け説明では、インストール本体に最低4GB、モデル用に「数十〜数百GB」の空きが別に要るとしている(出典: Ollama Windows)。
ただし、置き場を移しても VRAMの枠は1MBも増えない。置き場は資材置き場、VRAMは搬入口だ。ディスクの選び方はSSD増設の選び方、Ollama自体の入れ方はOllama導入手順にまとめてある。
まとめ。8GBで選ぶなら「全部載るサイズ」
測った範囲で言えるのは次の3つだ。
- VRAM 8GBのRTX 2070 SUPERで、全部載ったqwen3 8Bは66.82トークン/秒だった
- 37%があふれた14Bは7.6トークン/秒で、約9分の1に落ちた。GPU使用率も96%から13%に下がった
- 32BはVRAMとメモリを足しても置ききれず、0.02トークン/秒。32トークンに約30分かかった
8GBのGPUでローカルLLMを使うなら、ollama ps が「100% GPU」になるサイズを選ぶのが基準になる。VRAM別に載るモデルの目安はローカルLLMのPCスペック早見表、画像生成で8GBがどこまで動くかはSDXLの実測記事にある。
14B以上を常用したいなら、枠そのものを広げる話になる。今週のセール機をVRAM基準で仕分けた表と二刀流ランキングを置いておく。最強の1台より、載せたいモデルが「100% GPU」になる枠、この1点を外さない1台だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機・1台・2026年9月28日)での測定に基づく解説です。各モデル1条件の測定で、ドライバー・Ollamaの版・常駐アプリ・空きメモリ・コンテキスト長で結果は変わります。OLLAMA_MODELSの変更による速度の違いは測っていません。最新の仕様は各公式ドキュメントをご確認ください。
出典
- Ollama FAQ(ollama psのPROCESSOR表示・モデルの保存場所とOLLAMA_MODELS・Windowsの環境変数・既定のコンテキスト長4096): https://docs.ollama.com/faq
- Ollama Windows(OLLAMA_MODELSの設定・保存場所・必要な空き容量): https://docs.ollama.com/windows
- Ollama API ps(size・size_vram・context_length): https://docs.ollama.com/api/ps
- Ollama API generate(eval_count・eval_duration・load_duration・num_predict・num_ctx・seed): https://docs.ollama.com/api/generate
- Ollama qwen3 タグ一覧(8b-q4_K_M 5.2GB・14b-q4_K_M 9.3GB・32b-q4_K_M 20GB): https://ollama.com/library/qwen3/tags
- Qwen3-14B モデルカード(14.8Bパラメータ・思考モードの切り替え): https://huggingface.co/Qwen/Qwen3-14B
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER 8GB GDDR6・256-bit・Turing・215W): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- Ollama Windows版ダウンロード(Windows 10以降が必要): https://ollama.com/download/windows