カテゴリ: AI開発環境
 画像生成UIの違い — ComfyUI・Forge・AUTOMATIC1111を公式の対応モデル・更新状況・導入方法で比べる
画像生成のローカルUIの定番、ComfyUI・Forge・AUTOMATIC1111。系統の違い、公式の対応モデル、各リポジトリの最終更新日、Windowsでの導入方法を一次情報だけで並べ、今から入れるならどれかを整理する。
 LM Studioの導入手順(Windows) — 公式の動作要件・モデルの置き場・GPUオフロード・ローカルサーバーまで
LM Studioは、ローカルLLMを画面操作で落として動かせる無料アプリだ。Windowsの公式動作要件、Discoverでの入手、モデルの置き場、GPUオフロードとコンテキスト長、ローカルサーバーとlms CLIを公式ドキュメントだけで整理する。
 量子化(Q4・Q8・FP16)とVRAM — ローカルLLMの必要容量を公式のモデル表とKVキャッシュの式で計算する
ローカルLLMの必要VRAMは「重み(量子化で決まる)+KVキャッシュ(文脈の長さで決まる)」の足し算。llama.cppの量子化別サイズ表、モデル設定の層数・ヘッド数、Ollamaの設定項目から、8GB・12GB・16GBで何が載るかを電卓で出す。
 RadeonでローカルAIは使えるか — RX 9070 XTとROCm・Vulkan・DirectML、Ollama/ComfyUIの公式対応を仕分ける
RX 9070 XT(16GB)でOllamaとComfyUIは動くのか。AMDのROCm互換表、Ollama GPUドキュメント、ComfyUI README、DirectMLの現状を読み、WindowsとLinuxで通れる道を公式記載の範囲で整理した。
 ローカルAI実行中のGPU使用状況の確かめ方 — nvidia-smiのVRAM・使用率の読み方を実測ログで
ローカルAI実行中のGPUの様子は nvidia-smi で読める。RTX 2070 SUPER(8GB)でSDXLとOllamaを動かした実測ログを材料に、VRAM使用量・GPU使用率・電力の読み方と、1秒ごとに記録するコマンドを公式ドキュメントどおりに整理する。
 OllamaのモデルがVRAMからあふれると何が起きるか — RTX 2070 SUPER 8GBでqwen3 8B/14B/32Bを実測
RTX 2070 SUPER(VRAM 8GB)のOllamaでqwen3の8B・14B・32Bを実測。全部載る8Bは66.82トークン/秒、37%があふれた14Bは7.6、32Bは0.02。ollama psの読み方とOLLAMA_MODELSの公式手順も整理する。
 VRAM 8GBでSDXLはどこまで動くか — RTX 2070 SUPERで --lowvram・fp8・解像度・枚数を実測
RTX 2070 SUPER(VRAM 8GB)のComfyUIでSDXLを、既定・--lowvram・fp8の3モード×解像度・枚数の12条件で実測。全条件でエラーなく完走した結果と、--lowvramで差が出なかった理由を公式情報で整理する。
 ComfyUIポータブル版にManagerを入れる手順 — v0.37.0で有効化し、スナップショットで戻せる状態にするまで
ComfyUIポータブル版v0.37.0にComfyUI-Manager 4.2.2を公式手順で入れ、--enable-managerで起動してスナップショットを保存するまでを、RTX 2070 SUPER機の実行記録と公式情報で整理する。
 ローカルLLMをブラウザで使う — Open WebUIとOllamaをつなぐ公式手順(Docker/pip)と、つながらない時のポート整理
Open WebUIを入れると、Ollamaで動かすローカルLLMをChatGPT風の画面で使える。Docker・pipの公式コマンド、Ollamaとの接続先URL、3000/8080/11434の関係、更新とバックアップの手順を公式ドキュメントだけで整理する。
 ComfyUIの導入手順 — WindowsゲーミングPCにポータブル版/WSL2で入れて、fp8でVRAMを節約するまで
ComfyUIはポータブル版を展開してrun_nvidia_gpu.batを押せばブラウザで起動する。Desktop・ポータブル・WSL2の3ルート、CUDA 13.0とドライバ580の条件、fp8モデルと起動オプションを公式情報で整理する。
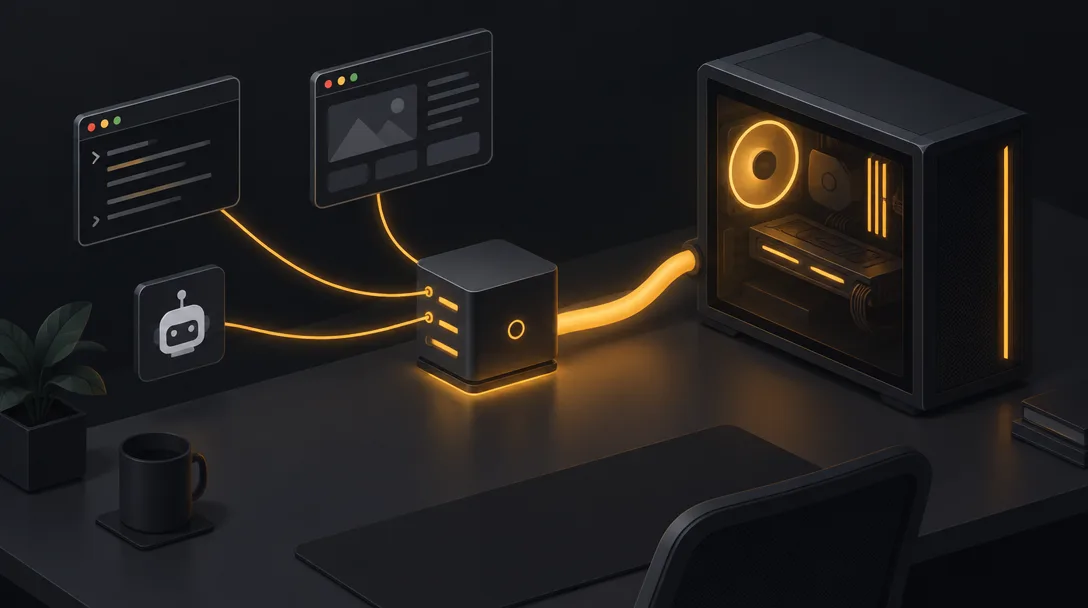 OllamaでローカルLLMを動かす手順 — WindowsゲーミングPC(WSL2/ネイティブ)で最初の1モデルを走らせるまで
OllamaはWindowsにインストールして「ollama run llama3.1」と打てば最初のローカルLLMが動く。ネイティブ版とWSL2の2ルート、pull/ps/rmなど公式コマンド、サーバー構成の図解、公式FAQにある詰まりどころを整理する。
 画像生成AIに必要なVRAMはいくつ? SD1.5 / SDXL / FLUX.1 / 動画生成をモデル別に整理
SD1.5・SDXL・FLUX.1・Wan2.xの動画生成まで、公式ドキュメントの推奨VRAMだけを表で整理。8GB/12GB/16GBで何が回るか、fp8やオフロードの逃げ道、Radeonの注意点も公式の範囲でまとめた。
 ローカルLLMを動かすPCスペック — VRAM別「載るモデル」早見表と、メインRAMで補う方法
ローカルLLM(Ollama / llama.cpp)を動かすPCスペックはVRAM容量でほぼ決まる。パラメータ数×ビット数の計算式、8〜32GBのVRAM別に載るモデル規模の目安、メインRAMへのオフロードを公式ドキュメント基準で整理する。
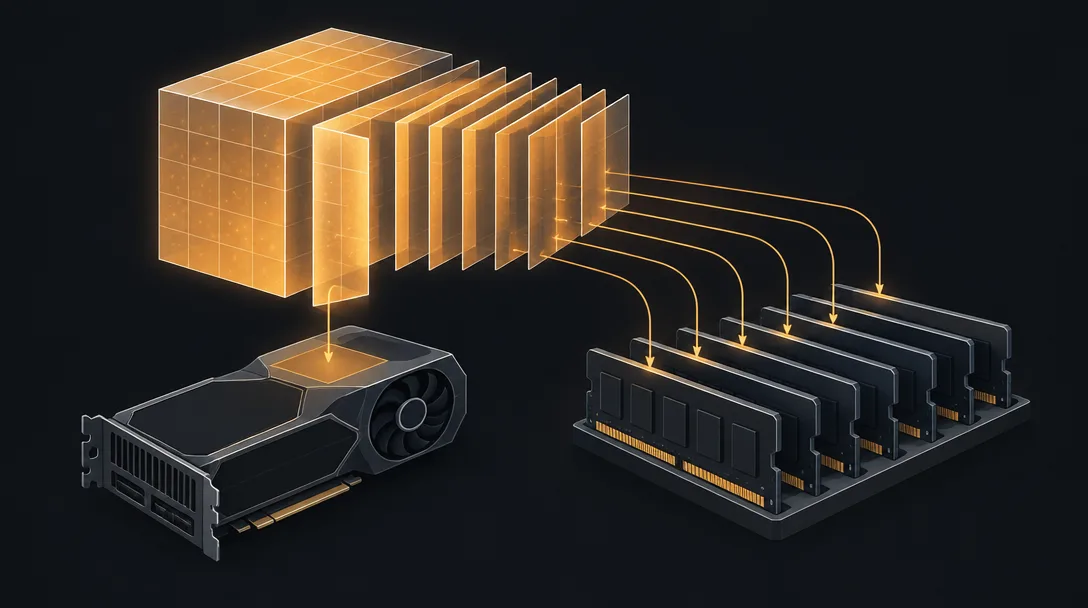 MiniMax M3がオープンウェイトで来た。428BはゲーミングPCで動くのか、正直に計算してみる
2026年6月公開のMiniMax M3(総428B・アクティブ23BのMoE、1Mコンテキスト)はローカルで動かせるのか。量子化後のサイズを概算し、ゲーミングPCで現実的に狙える構成(VRAMよりメインRAM)を整理する。
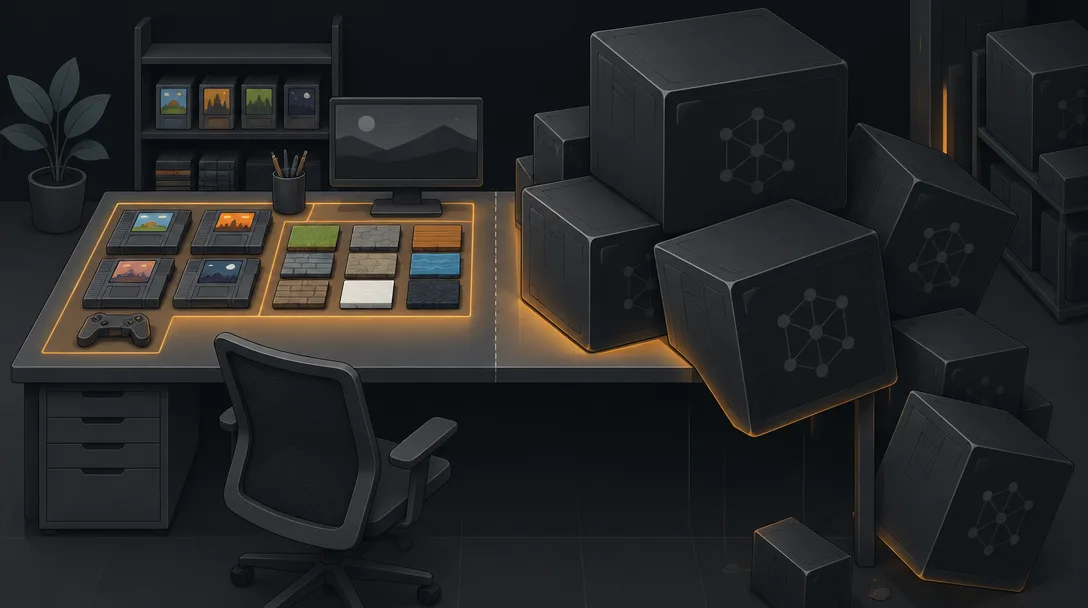 VRAMとは何か — ゲームとAIで「足りない」の意味がまったく違う話
VRAM(ビデオメモリ)の役割をゲーム用途とAI用途で比較。ゲームは「画質を下げれば動く」、AIは「載らなければ動かない」。この違いがGPU選びをどう変えるかを解説する。
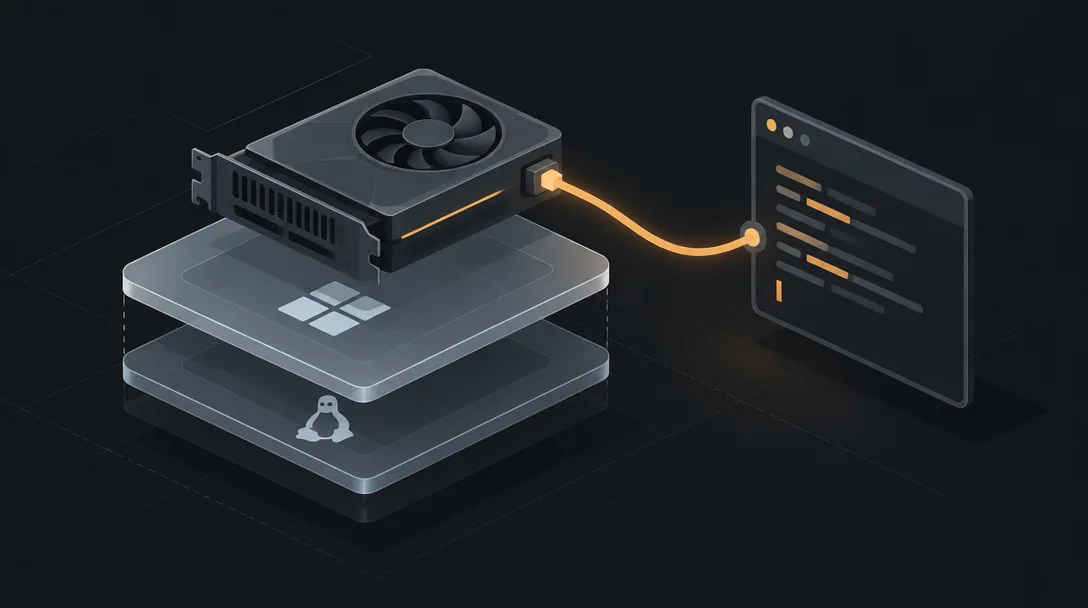 WSL2 + CUDA で始めるAI開発環境セットアップ完全ガイド
WindowsゲーミングPC上でWSL2+CUDAを使ったAI開発環境を構築する完全ガイド。Python、PyTorch、Stable Diffusionまで一気にセットアップ。