量子化(Q4・Q8・FP16)とVRAM — ローカルLLMの必要容量を公式のモデル表とKVキャッシュの式で計算する
ローカルLLMの必要VRAMは「重み(量子化で決まる)+KVキャッシュ(文脈の長さで決まる)」の足し算。llama.cppの量子化別サイズ表、モデル設定の層数・ヘッド数、Ollamaの設定項目から、8GB・12GB・16GBで何が載るかを電卓で出す。
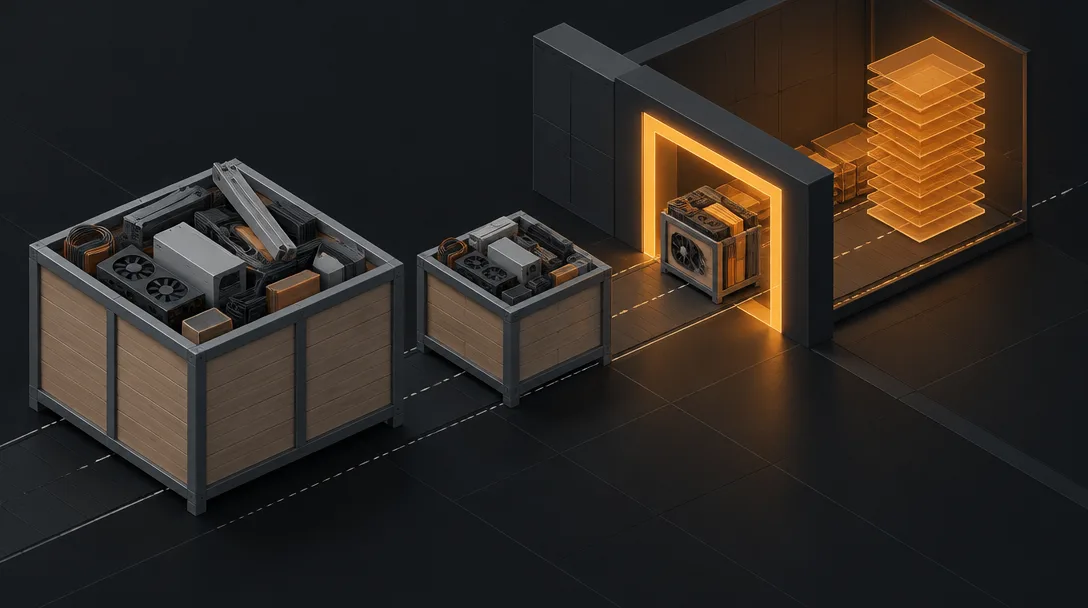
必要なVRAMは「重み × 量子化」と「KVキャッシュ × 文脈の長さ」の足し算で、どちらも公式の数字から電卓で出せる。
「8BならVRAM 8GBで動く」——半分は正しい。Q4で4K文脈なら収まるが、Q8に上げたり文脈を32Kに伸ばしたりすると、同じ8Bでも枠を超える。
この記事は「動かしてみた」記事ではない。llama.cppの量子化別サイズ表、モデルの設定ファイル(層数・ヘッド数)、Ollamaの公式ドキュメントだけを材料に、計算の手順を並べたものだ。
載る/載らないの早見表はローカルLLMのPCスペック記事にまとめた。今回はその「表の裏の計算」を開く。
量子化は「1つの重みを何bitで持つか」を決める工程
LLMの重みは本来16bit(FP16/BF16)で配られる。Qwen3-8Bの設定ファイルも torch_dtype: bfloat16 だ(出典: Qwen3-8B config.json)。
これを8bit・4bitへ丸めて小さくするのが量子化。GGUF形式の量子化タイプは、Hugging Faceのドキュメントに1重みあたりのビット数(bpw)つきで並んでいる。
| タイプ | 公式の説明(要約) | bpw(公称) |
|---|---|---|
| F16 / BF16 | 16bit浮動小数点 | 16 |
| Q8_0 | 8bit。32個ずつのブロックにスケール値 | 約8.5(下表の実測サイズから) |
| Q6_K | 6bit。16ブロック×16重みのスーパーブロック | 6.5625 |
| Q5_K | 5bit。8ブロック×32重み | 5.5 |
| Q4_K | 4bit。8ブロック×32重み | 4.5 |
| Q3_K | 3bit | 3.4375 |
| Q2_K | 2bit | 2.625 |
出典: Hugging Face GGUFドキュメント(Quantization Types)。Q8_0の値はllama.cppのサイズ表の8.5008bpw。
ポイントは**「4bitなのに4.5bit」**になるところ。ブロックごとにスケール値と最小値を別に持つので、そのぶんが上乗せされる。Q8_0やQ4_0は同ドキュメントで「レガシー」扱いとされている。
Q4_K_Mの「K」はK-quant方式、「M」はS/M/Lと並ぶ配合の段階の真ん中だ(サイズ表にもQ3_K_S・Q3_K_M・Q3_K_Lが並ぶ)。K-quantは層ごとに精度の違うタイプを混ぜる配合で、だから実効bpwは4.5ちょうどにならない。llama.cppの量子化ツールにも、混合をやめて全テンソルを同じタイプにする --pure オプションが別にある(出典: llama.cpp quantize README)。
同じ8Bで1.87GiB〜14.96GiB。公式のサイズ表を読む
llama.cppの量子化READMEには、Llama 3.1 8Bを各タイプで量子化したときのbpwとサイズが表で載っている。主要どころを抜くとこうなる。
| タイプ | bpw(公称) | サイズ(GiB) |
|---|---|---|
| IQ1_S | 2.0042 | 1.87 |
| Q2_K | 3.1593 | 2.95 |
| Q3_K_M | 3.9960 | 3.74 |
| Q4_K_M | 4.8944 | 4.58 |
| Q5_K_M | 5.7036 | 5.33 |
| Q6_K | 6.5633 | 6.14 |
| Q8_0 | 8.5008 | 7.95 |
| F16 | 16.0005 | 14.96 |
出典: llama.cpp quantize README(meta-llama/Llama-3.1-8B)。
同じモデルが、量子化だけで約8倍の幅を持つ。現場でいえば、同じ資材を「バラのまま運ぶ」か「圧縮梱包して運ぶ」かの違いだ。搬入口(VRAM)の幅は変わらないから、梱包の仕方で入る・入らないが決まる。
なお単位に注意。この表はGiB(1024³バイト)、Ollamaのライブラリ表示はGB。4.58GiBは約4.9GBで、Ollamaの llama3.1:8b 既定タグ4.9GBと揃う(出典: Ollamaライブラリ llama3.1)。
計算式: パラメータ数 × bpw ÷ 8
重みの容量は次の式で概算できる。
重みの容量(バイト) ≒ パラメータ数 × bpw ÷ 8
Qwen3-14B(公称14.8B)で試す。bpwは上の表のLlama 3.1 8Bの値を借りた概算だ。
| タイプ | 概算 | Ollama公称サイズ |
|---|---|---|
| Q4_K_M(4.8944bpw) | 14.8B × 4.8944 ÷ 8 ≒ 9.1GB | 9.3GB |
| Q8_0(8.5008bpw) | 14.8B × 8.5008 ÷ 8 ≒ 15.7GB | 16GB |
| FP16(16bpw) | 14.8B × 16 ÷ 8 ≒ 29.6GB | 30GB |
出典: Qwen3-14Bモデルカード(14.8B)、Ollamaライブラリ qwen3 タグ一覧。
概算と公称は数%の差で収まる。差が出るのは、モデルごとに層の構成や配合が違うからだ。**買う前の見積もりなら、この式で十分足りる。**ダウンロード前ならOllamaのタグ一覧の数字が正解だ。
ここで分かるのは、14BのQ8_0は16GB、つまりRTX 5070 Ti / 5080の16GBにも重みだけで並ぶということ。16GBのGPUで14Bを動かすなら、Q4_K_Mが現実の線になる。
見落とされるもう1つの荷物: KVキャッシュ
重みが入っても、それで終わりではない。会話の文脈を覚えておくKVキャッシュが、トークン数に比例して積み上がる。
NVIDIAの技術ブログは、トークンあたりのKVキャッシュの容量をこう示している。
2 × 層数 × (ヘッド数 × ヘッドの次元) × 精度のバイト数
先頭の2はキー(K)とバリュー(V)の2本ぶん。同じ記事は、GQA(グループ化クエリ注意)がKVのヘッド数を減らしてKVキャッシュのメモリを小さくする、とも書いている(出典: NVIDIA Technical Blog)。だから最近のモデルでは、ヘッド数に「KV側のヘッド数」を入れる。
Qwen3-8Bの設定ファイルは、層数36・KVヘッド数8・ヘッドの次元128(出典: Qwen3-8B config.json)。f16(2バイト)で計算すると、
2 × 36 × 8 × 128 × 2 = 147,456バイト/トークン
| 文脈の長さ | Qwen3-8B(36層) | Qwen3-14B(40層) |
|---|---|---|
| 4,096トークン | 約0.60GB | 約0.67GB |
| 8,192トークン | 約1.21GB | 約1.34GB |
| 32,768トークン | 約4.83GB | 約5.37GB |
14Bは層数40・KVヘッド数8・次元128(出典: Qwen3-14B config.json)。どちらもKVキャッシュ f16 での計算値で、実行時の作業領域は含まない。
32Kはどちらのモデルもネイティブで扱える長さだ(出典: Qwen3-8B / 14B モデルカード)。**8Bに32Kを丸ごと持たせると、KVキャッシュだけで重み(5.2GB)に近い容量になる。**図の2本目がそれで、8GBの枠を超える。
VRAMを空ける3つのレバー
足りないときに動かせるレバーは3本ある。段取り八分、どれを引くかを先に決めておく。
- 重みの量子化を下げる: Q8_0→Q4_K_Mで、8Bなら8.9GB→5.2GB(Ollama公称)
- 文脈を短くする: Ollamaの既定は4096トークン。
OLLAMA_CONTEXT_LENGTHかnum_ctxで変えられる(出典: Ollama FAQ)。長くするほどKVキャッシュが増える - KVキャッシュを量子化する:
OLLAMA_KV_CACHE_TYPEにq8_0を指定すると、f16の約1/2のメモリで精度の低下はごく小さい、q4_0は約1/4で低下は小〜中、と公式に書かれている。Flash Attentionが有効なときに働き、設定は全モデル共通だ(出典: Ollama FAQ)
図の3本目は、Q4_K_M+32K文脈でKVキャッシュをq8_0にした計算だ。約7.6GBで8GBの枠に収まる。ただし作業領域の余白はほぼ残らない。
載ったかどうかは ollama ps のPROCESSOR列で確かめる。「100% GPU」なら全部VRAM、「48%/52% CPU/GPU」のような表示ならシステムメモリにあふれている(出典: Ollama FAQ)。あふれたときの挙動はqwen3をVRAM 8GBで測った記事、VRAMの見方はnvidia-smiの記事に書いた。
VRAM容量ごとの計算の当てはめ
ここまでの式を、GPUのVRAMに当てはめるとこうなる(重みはOllama公称、KVは上の計算値)。
- 8GB: 8BのQ4_K_M(5.2GB)+4K〜8K文脈。32Kを使うならKVキャッシュの量子化が前提
- 12GB: 8BのQ8_0(8.9GB)+4K文脈、または14BのQ4_K_M(9.3GB)+短めの文脈
- 16GB: 14BのQ4_K_M+長めの文脈。14BのQ8_0(16GB)は重みだけで枠いっぱい
12GBと16GBのどちらを取るかの比較はRTX 5060 Ti 16GBと5070 12GBの記事で掘った。
型番より先に「何Bを・どの量子化で・何トークン持たせたいか」を決める。それが決まればVRAMの必要量は電卓で出る。あとは今週のセール機をVRAM基準で仕分けた表と二刀流ランキングで、その数字を満たす機体を相見積もりすればいい。
最強の1台を探すより、「重みと文脈の両方が入る枠」を外さない1台を選ぶ。計算を一度やっておけば、それは外さない。
※本記事は公開情報(各公式ドキュメント・モデルカード・設定ファイル)に基づく解説です。KVキャッシュの値は公式の式と設定値からの計算で、実行時の作業領域・ランタイム・ドライバにより実際の使用量は変わります。量子化による品質の変化はモデルごとに異なるため、各モデルの公式情報をご確認ください。
出典
- llama.cpp quantize README(Llama 3.1 8Bの量子化別bpw・サイズ、
--pureほかのオプション): https://github.com/ggml-org/llama.cpp/blob/master/tools/quantize/README.md - Hugging Face GGUFドキュメント(量子化タイプとbits-per-weight): https://huggingface.co/docs/hub/gguf
- NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(KVキャッシュの式、GQA): https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/
- Ollama FAQ(既定コンテキスト長、OLLAMA_CONTEXT_LENGTH、KVキャッシュ量子化、Flash Attention、ollama ps): https://docs.ollama.com/faq
- Ollamaライブラリ qwen3 タグ一覧(8b 5.2GB / 8b-q8_0 8.9GB / 8b-fp16 16GB / 14b 9.3GB / 14b-q8_0 16GB / 14b-fp16 30GB): https://ollama.com/library/qwen3/tags
- Ollamaライブラリ llama3.1(8b 4.9GB): https://ollama.com/library/llama3.1
- Qwen3-8B モデルカード(8.2B、36層、GQA 32/8、32,768トークン): https://huggingface.co/Qwen/Qwen3-8B
- Qwen3-8B config.json(層数・KVヘッド数・head_dim・bfloat16): https://huggingface.co/Qwen/Qwen3-8B/blob/main/config.json
- Qwen3-14B モデルカード(14.8B、40層、GQA 40/8、32,768トークン): https://huggingface.co/Qwen/Qwen3-14B
- Qwen3-14B config.json(層数・KVヘッド数・head_dim): https://huggingface.co/Qwen/Qwen3-14B/blob/main/config.json