RTX 5060 Ti 16GB vs RTX 5070 12GB — AI用途はVRAM容量か速度か、公式スペックで仕分ける
RTX 5060 Ti 16GBとRTX 5070 12GBをNVIDIA公式の公称値で比較。VRAMは5060 Tiが4GB多く、帯域とCUDAコアは5070が上。12GBと16GBの間に落ちるモデルを使うかどうかで選ぶ基準と、8GB版との取り違えの注意点を整理。
使いたいモデルが12GBに収まるならRTX 5070、12GBと16GBの間に落ちるならRTX 5060 Ti 16GBだ。
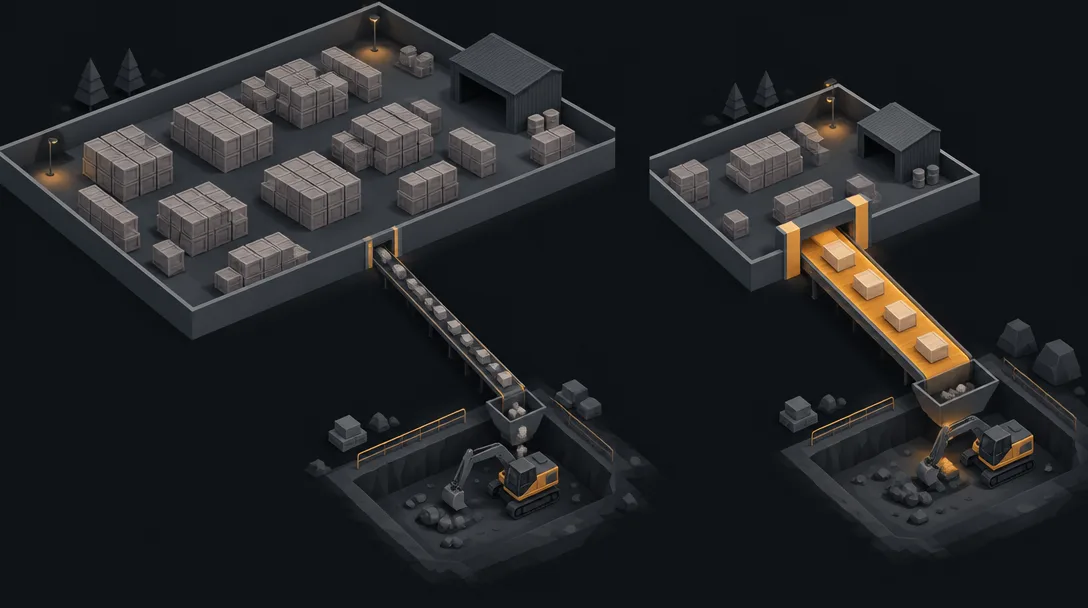
この2枚は、値段の近さのわりに性格が逆を向いている。5060 Tiは資材置き場(VRAM)が広く、5070は搬出口(帯域)と重機(CUDAコア)が太い。
前にRTX 5060と5070の比較を書いたとき、5060 Ti 16GBは「第3の選択肢」として触れただけだった。今回はそこを正面から比べる。
俺はこの2枚の実機を持っていないので、この記事はNVIDIA公式の仕様表と、出典を明記できる公表データだけで組む。
公式スペック比較(NVIDIA公式、公称値)
| RTX 5060 Ti(16GB版) | RTX 5070 | |
|---|---|---|
| CUDAコア数 | 4,608 | 6,144 |
| ブーストクロック | 2.57GHz | 2.51GHz |
| VRAM | 16GB GDDR7 | 12GB GDDR7 |
| メモリインターフェイス幅 | 128-bit | 192-bit |
| メモリ帯域幅 | 448GB/s | 672GB/s |
| AI TOPS | 759 | 988 |
| グラフィックスカード電力 | 180W | 250W |
| 必要なシステム電力 | 600W | 650W |
| 電源コネクタ | PCIe 8ピン×1 | PCIe 8ピン×2 |
出典: NVIDIA公式 RTX 5060ファミリー・RTX 5070ファミリーの仕様表、帯域幅はNVIDIA公式の比較ページ(2026-10-06閲覧)。電源コネクタはいずれも「または300W以上のPCIe Gen 5ケーブル1本」と併記されている(アダプター付属)。
公称値の比で見ると、5070はCUDAコアが約1.33倍、帯域が1.5倍、AI TOPSが約1.3倍。逆にVRAMは5060 Tiが4GB多い。
どちらが上かではなく、何が詰まる現場かで答えが変わる組み合わせだ。
「載るかどうか」は器の大きさで決まる
AIのモデルは、VRAMに丸ごと載るかどうかで扱いが変わる。まずはOllamaの公式ライブラリに表示されているファイルサイズ(公称値)を、12GBと16GBの枠に当ててみる。
| モデル(Ollamaライブラリ) | 表示サイズ | 12GBの枠 | 16GBの枠 |
|---|---|---|---|
| qwen3:8b | 5.2GB | 収まる | 収まる |
| gemma3:12b | 8.1GB | 収まる | 収まる |
| qwen3:14b | 9.3GB | 収まる | 収まる |
| gpt-oss:20b | 14GB | 収まらない | 収まる |
| gemma3:27b | 17GB | 収まらない | 収まらない |
| qwen3:32b | 20GB | 収まらない | 収まらない |
出典: Ollamaライブラリ qwen3・gemma3・gpt-ossの表示(2026-10-06閲覧)。
この表はファイルサイズだけの比較だ。NVIDIAの技術ブログは、会話の履歴を覚えておくKVキャッシュのメモリ量が系列長に比例して増えると説明している(出典: NVIDIA Technical Blog)。だから「ファイルが枠ぎりぎりに収まる」は、実際には収まらない側に倒れうる。
12GBと16GBの差が効くのは、表のgpt-oss:20bのような「12GBを超えて16GBに収まる」帯のモデルだ。逆にgemma3:27bやqwen3:32bは、どちらの枠にも入らない。ここで4GBの差は効かない。
画像生成でも同じ構図がある。NVIDIAの技術ブログでは、FLUX.1 [dev]をTensorRTの低VRAMモードで動かしたときのVRAM消費が、FP8で14.9GB、FP4で11.1GB(公称値)と示されている(出典: NVIDIA Technical Blog)。FP8は16GBの枠に収まり12GBには収まらない。FP4ならどちらにも収まる。
ComfyUIの公式サンプルページも、モデルの重みをfp8で読み込むとメモリ使用量が半分になる一方、品質がわずかに落ちうると書いている(出典: ComfyUI Examples: Flux)。12GBの枠は「精度を一段落として収める」前提の器だと考えておくと読み違えにくい。
「載ったあとの速さ」は搬出口の太さで決まる
モデルが両方の枠に収まるなら、話は逆になる。
NVIDIAの技術ブログは、LLMの文章生成(decode)の段階について、遅さを決めるのは計算の速さではなくメモリからGPUへデータを運ぶ速さで、メモリ律速の処理だと説明している(出典: NVIDIA Technical Blog)。
この説明に当てはめると、qwen3:14bのように両方に収まるモデルでは、帯域が1.5倍ある5070のほうが文章生成で有利になる、というのが公称値から引ける線だ。何倍速くなるかは、モデル・ソフト・設定で変わるので、ここでは書かない。
画像生成のように計算量の多い処理では、CUDAコア数とAI TOPSの差(約1.3倍)も効いてくる。こちらも5070側に分がある。
現場でいえば、5060 Tiは資材置き場が広いが搬出口が細い現場、5070は置き場が狭いが搬出口が太い現場だ。置き場に資材が全部入るなら、搬出口が太いほうが工程は早く回る。
あふれた瞬間に、速さの話はひっくり返る
問題は、資材が置き場に入りきらなかったときだ。
Ollamaの公式FAQには、ollama ps の PROCESSOR 欄で、モデルがGPUに全部載ったか(100% GPU)、GPUとメインメモリに分かれたか(例: 48%/52% CPU/GPU)を確かめられると書かれている(出典: Ollama FAQ)。
分かれた状態では、あふれた分をメインメモリ側から扱うことになる。5070の太い搬出口は、VRAMの中にある資材にしか効かない。
12GBからあふれるモデルを常用するなら、5070の帯域の優位は当てにできない。この「あふれると何が起きるか」は、手元の8GB機で測ったOllamaのモデルが VRAMからあふれる記事にまとめてある。
電源と、8GB版との取り違え
電源の段取りも違う。公称値で、5060 Tiはカード電力180W・必要システム電力600W・8ピン1本。5070は250W・650W・8ピン2本だ。
BTOで買うなら電源はショップ側で組まれるが、後からGPUだけ載せ替える場合はここが効く。詳しくはGPU換装と電源容量の記事に書いた。
もうひとつ、RTX 5060 Tiには8GB版がある。NVIDIA公式の仕様表でも「16 GB / 8 GB GDDR7」と並記されていて、型番だけでは見分けがつかない。
8GB版を選ぶと、この記事の「器が広い」という前提が丸ごと崩れる。購入画面の仕様欄で「16GB」の表記を確かめるのが、KY活動でいう指差し確認だ。
どっちを選ぶか(用途別の判定表)
| 使い方 | RTX 5060 Ti 16GB | RTX 5070 12GB |
|---|---|---|
| 8B〜14BクラスのLLM(Q4) | 載る | 載る・帯域で有利 |
| 12〜16GBに落ちるLLM(例: gpt-oss:20b) | 載る | あふれる |
| 27B以上のLLM(Q4) | あふれる | あふれる |
| FLUX.1 [dev] FP8(低VRAMモード) | 収まる | 収まらない |
| FLUX.1 [dev] FP4(低VRAMモード) | 収まる | 収まる・演算で有利 |
| 電源の余裕 | 600W・8ピン1本 | 650W・8ピン2本 |
判定は公称値と公表データから俺が引いた線で、実測ではない。
使いたいモデルがまだ決まっていないなら、「12GBと16GBの間に落ちるモデルを使う予定があるか」だけ自分に聞けばいい。あるなら5060 Ti 16GB、ないなら5070。段取り八分で、ここを先に決めておけば後で買い直さずに済む。
GPU以外の配分はローカルLLM向けPCスペックの早見表も参考になる。
結論
容量で詰まる現場ならRTX 5060 Ti 16GB、速さで詰まる現場ならRTX 5070 12GB。そして5060 Tiを選ぶなら、購入画面の「16GB」表記まで確認する。
今週のセールでこの2枚の搭載機がいくらで出ているかは、今週のセール機をVRAM基準で仕分けた表で見られる。VRAMとメモリの両方で線を引いた二刀流ランキングもある。
最強の1台より、外せない2点を外さない1台。この比較の2点は、使うモデルの大きさとVRAMの表記だ。
※本記事はNVIDIA公式サイトの公称スペックと、出典を明記した公表データに基づく解説です。筆者による実測は含みません。モデルのサイズや仕様は記載時点のもので、更新により変わることがあります。
出典
- NVIDIA「GeForce RTX 5060 ファミリー」仕様: https://www.nvidia.com/ja-jp/geforce/graphics-cards/50-series/rtx-5060-family/
- NVIDIA「GeForce RTX 5070 ファミリー」仕様: https://www.nvidia.com/ja-jp/geforce/graphics-cards/50-series/rtx-5070-family/
- NVIDIA「GeForce グラフィックスカード比較」(メモリ帯域幅): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/
- NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」: https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/
- NVIDIA Technical Blog「NVIDIA TensorRT Unlocks FP4 Image Generation for NVIDIA Blackwell GeForce RTX 50 Series GPUs」: https://developer.nvidia.com/blog/nvidia-tensorrt-unlocks-fp4-image-generation-for-nvidia-blackwell-geforce-rtx-50-series-gpus/
- ComfyUI Examples「Flux」: https://comfyanonymous.github.io/ComfyUI_examples/flux/
- Ollama FAQ: https://docs.ollama.com/faq
- Ollamaライブラリ「qwen3」: https://ollama.com/library/qwen3/tags
- Ollamaライブラリ「gemma3」: https://ollama.com/library/gemma3/tags
- Ollamaライブラリ「gpt-oss」: https://ollama.com/library/gpt-oss/tags