ローカルAI実行中のGPU使用状況の確かめ方 — nvidia-smiのVRAM・使用率の読み方を実測ログで
ローカルAI実行中のGPUの様子は nvidia-smi で読める。RTX 2070 SUPER(8GB)でSDXLとOllamaを動かした実測ログを材料に、VRAM使用量・GPU使用率・電力の読み方と、1秒ごとに記録するコマンドを公式ドキュメントどおりに整理する。
GPUの様子は「VRAMがどれだけ埋まっているか」と「GPUがどれだけ手を動かしているか」の2つを、別々に読む。片方だけ見ると判断を誤る。
ローカルAIが遅い、落ちる、というとき、まず疑うのはGPUだ。
ただ、タスクマネージャーの数字を1つ眺めただけでは、原因の当たりはつかない。手元のRTX 2070 SUPER機(i7-9700K/メモリ16GB)でSDXLとOllamaを動かしたときに記録した nvidia-smi のログを材料に、読み方を整理する。1台・1回の測定で、環境が違えば結果は変わる。
nvidia-smiの画面は、この4か所だけ読めばいい
nvidia-smiはNVIDIAのドライバーに付いてくるコマンドだ。Windowsならコマンドプロンプトで nvidia-smi と打てば出る。
SDXLで1024×1024の画像を生成している最中(開始から約16秒後)に取った出力がこれだ。
| NVIDIA-SMI 617.14                 KMD Version: 617.14        CUDA UMD Version: 13.4     |
...
|   0  NVIDIA GeForce RTX 2070 ...  WDDM  |   00000000:01:00.0  On |                  N/A |
| 40%   76C    P2            210W /  215W |    6089MiB /   8192MiB |    100%      Default |
...
|    0   N/A  N/A           15528      C   ...ble\python_embeded\python.exe      N/A      |
現場でいえば、計器盤だ。全部の針を読む必要はない。見るのは次の4か所になる。
| 欄 | この時の値 | 公式ドキュメントでの意味 |
|---|---|---|
| Memory-Usage | 6089MiB / 8192MiB | 使用中のメモリ / VRAMの総量 |
| GPU-Util | 100% | 直近の計測期間のうち、GPUで処理(カーネル)が1つ以上動いていた時間の割合 |
| Pwr:Usage/Cap | 210W / 215W | ボード全体の消費電力 / 電力の上限 |
| Perf | P2 | 性能状態。P0が最高性能、P12が最低 |
意味の欄は、NVIDIAのnvidia-smiドキュメントの定義を訳したものだ(出典: NVIDIA nvidia-smi documentation)。RTX 2070 SUPERの公称値はメモリ8GB GDDR6、グラフィックスカード電力215Wで、画面の「8192MiB」「215W」と合う(出典: NVIDIA GeForce RTX 20シリーズ比較)。
温度の76Cは、GPUコアの温度(摂氏)だ。
プロセス一覧の「C」は計算(Compute)のプロセス、「G」は画面描画(Graphics)のプロセスを表す(出典: NVIDIA nvidia-smi documentation)。今回のComfyUIは「C」で出ていた。ただしこのWindows機(WDDMモード)では、プロセスごとのメモリ使用量の欄が N/A になっていて、どのアプリが何MiB使っているかまではここでは読めなかった。
落とし穴1: GPU-Utilは「どれだけ頑張っているか」ではない
GPU-Utilの100%は、「GPUの計算能力を100%使い切っている」という意味ではない。
公式の定義は「計測期間のうち、処理が1つ以上動いていた時間の割合」だ。計測期間は製品によって1秒〜1/6秒とされている(出典: NVIDIA nvidia-smi documentation)。つまり、休まず何かしら動いていれば100%になる。
逆に、使用率が低いときは「GPUが手待ちになっている」と読める。Ollamaでqwen3を読み込んだ状態の記録がわかりやすい。
| モデル | VRAMに載った割合(ollama ps) | VRAM使用(nvidia-smi) | GPU使用率 |
|---|---|---|---|
| qwen3:8b-q4_K_M | 100% | 5,961MiB | 96% |
| qwen3:14b-q4_K_M | 63% | 6,697MiB | 13% |
| qwen3:32b-q4_K_M | 29% | 6,697MiB | 0% |
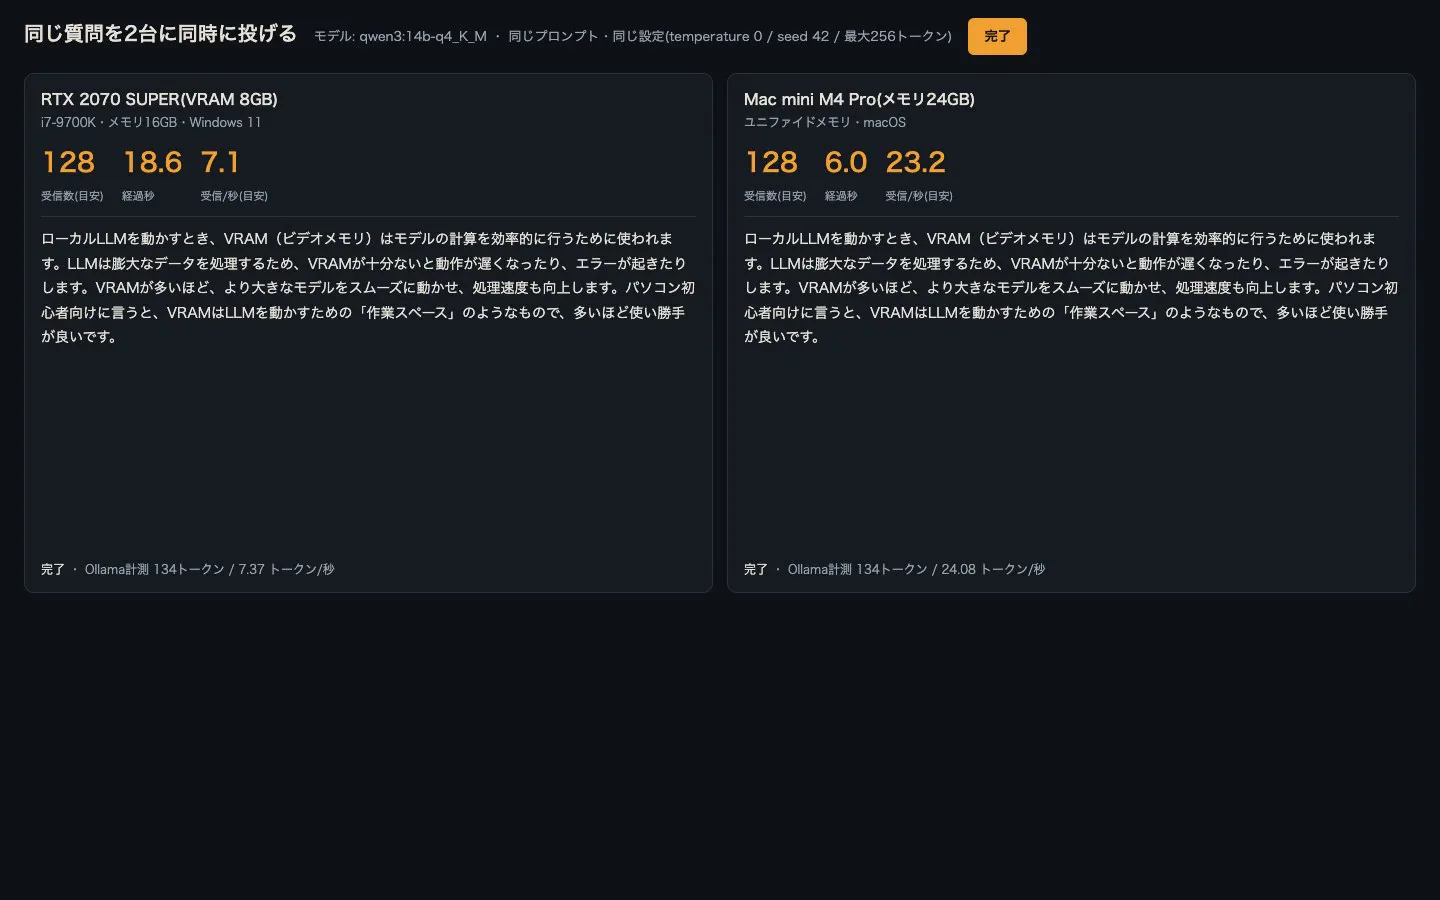
14Bは、VRAM使用量だけ見れば8Bより多い。なのにGPU使用率は96%から13%に落ちた。
VRAMに入りきらなかった分をメインメモリ側で処理している間、GPUが待たされていると考えられる(記録した数値からの推測で、内部の処理までは測っていない)。生成速度は8Bが66.82トークン/秒、14Bが7.6トークン/秒だった。詳しくはOllamaのモデルがVRAMからあふれたときの実測にまとめてある。
だから「GPU使用率が低い=GPUに余裕がある」とは限らない。VRAMがあふれていないかを、ollama psで先に確かめる。公式FAQでは、PROCESSOR欄が「100% GPU」なら全部GPU、「48%/52% CPU/GPU」のような表示なら両方に分かれて載っている(出典: Ollama FAQ)。
落とし穴2: VRAMは1回見ただけでは足りない
さっきの画面ではVRAMは6089MiBだった。ところが、同じ条件の生成を約1.3〜1.4秒ごとに記録した別の回では、最大値は7,811MiBまで上がっていた。
1枚の生成(18.32秒)の間、VRAMは6,019MiBで平らに続き、終盤に7,811MiBの山が来て、終わると3,779MiBに下がった。GPU使用率はほぼ100%のままだ。
終盤の山は、潜在画像を絵に戻すVAEの処理の時間帯と重なると見ているが、ノードごとのVRAMは測っていないので推測にとどまる。
言えるのは、たまたま開いた瞬間の1回の値では、山を見逃すということだ。KY活動でいえば、朝の1回の点検で足りる現場と、作業中に何度も見回る現場がある。VRAMは後者だ。
4枚まとめて生成したときも、VRAMは7,307〜7,310MiBでしばらく平らに続いたあと、一瞬718MiBまで下がり、また4,430MiBに上がっていた。山も谷もある。
なお、測ったすべての条件でVRAMの最大値は7,256〜7,902MiBと8GBの枠の9割前後まで来たが、VRAM不足のエラーは1件も出ていない。「枠ぎりぎり=失敗」ではない。ComfyUIがメインメモリ側に逃がす仕組みを持っているためだと考えられるが、そこは切り分けていない。条件ごとの数値はSDXLをVRAM 8GBで動かした実測にある。
1秒ごとに記録するコマンド
時系列で見るには、--query-gpu で欲しい項目だけ指定し、-l で繰り返す。NVIDIAのサポート記事に載っている形を、ローカルAI向けに項目を絞るとこうなる(出典: NVIDIA Useful nvidia-smi Queries)。
nvidia-smi --query-gpu=timestamp,utilization.gpu,memory.used,memory.total,power.draw,temperature.gpu,pstate --format=csv -l 1 -f gpu-log.csv--query-gpuはカンマ区切りで項目を並べる。--format=csvは必須(出典: NVIDIA nvidia-smi documentation)-l 1で1秒ごとに出力する。数字を省くと既定は5秒(出典: 同上)-fでファイルに書き出す(出典: NVIDIA Useful nvidia-smi Queries)。止めるときは Ctrl+C
段取り八分で、AIを走らせる前にこれを別ウィンドウで流しておく。終わったらCSVの memory.used の最大値と、utilization.gpu が低い時間帯を探す。この2つで「枠が足りないのか」「GPUが待たされているのか」の当たりがつく。
タスクマネージャーとの違い
Windowsのタスクマネージャーにも「GPU」の欄がある。Microsoftの開発者ブログによると、全体のGPU使用率は「いちばん忙しいエンジン」の使用率を代表値として表示する方式で、既定では4つのエンジンのグラフが出る(出典: Microsoft DirectX Developer Blog)。
エンジン名をクリックすると別のエンジンに切り替えられる。AIの計算が既定の4つに入っていなければ、グラフが低いまま見えることがある。
メモリも2種類ある。
| タスクマネージャーの表示 | 公式の説明 |
|---|---|
| 専用GPUメモリ | GPU専用に確保されたメモリ(グラボならVRAM) |
| 共有GPUメモリ | GPUとCPUのどちらも使える、通常のシステムメモリ |
「共有GPUメモリ」はVRAMではない(出典: Microsoft DirectX Developer Blog)。ここが増えていたら、搬入口に入りきらない資材を外の仮置き場に積んでいる状態だ。VRAMの枠を見たいなら、専用GPUメモリかnvidia-smiのmemory.usedを見る。
まとめ。読むのは「枠」と「手待ち」の2つ
測った範囲で言えるのは次の3つだ。
- GPU-Utilは「処理が動いていた時間の割合」。100%でも能力を使い切った意味ではなく、低いときはVRAMのあふれを疑う。qwen3 14Bでは13%まで落ちた
- VRAMは1回の値では山を見逃す。SDXL 1024×1024の1枚で、ある瞬間の画面は6,089MiB、約1.3秒ごとの記録では最大7,811MiBだった
- タスクマネージャーの「共有GPUメモリ」はVRAMではない
ログを取って「枠が足りない」とはっきりしたら、設定で粘るか、枠そのものを広げるかの判断になる。VRAM別に載るモデルの目安はローカルLLMのPCスペック早見表、枠を広げる候補は今週のセール機をVRAM基準で仕分けた表と二刀流ランキングに置いてある。
最強の1台より、memory.usedの山が枠に収まる1台。外せないのはこの1点だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機・1台・2026年9月28日)での測定に基づく解説です。各条件1回の測定で、ドライバー・アプリの版・常駐アプリ・画面の解像度で結果は変わります。記録したVRAM使用量には画面表示の分も含みます。最新の仕様は各公式ドキュメントをご確認ください。
出典
- NVIDIA nvidia-smi documentation(Memory Usage・Utilizationの定義と計測期間・Power Draw・Performance State・プロセス種別C/G・–query-gpu・–format=csv・-l): https://docs.nvidia.com/deploy/nvidia-smi/index.html
- NVIDIA Useful nvidia-smi Queries(–query-gpuの項目名・-l・-fでのログ記録): https://nvidia.custhelp.com/app/answers/detail/a_id/3751/~/useful-nvidia-smi-queries
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER 8GB GDDR6・256-bit・Turing・215W): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- Microsoft DirectX Developer Blog「GPUs in the Task Manager」(専用・共有GPUメモリ、使用率は最も忙しいエンジン、既定4エンジン): https://devblogs.microsoft.com/directx/gpus-in-the-task-manager/
- Ollama FAQ(ollama psのPROCESSOR表示): https://docs.ollama.com/faq
- Ollama API ps(size・size_vram): https://docs.ollama.com/api/ps