VRAM 8GBでSDXLはどこまで動くか — RTX 2070 SUPERで --lowvram・fp8・解像度・枚数を実測
RTX 2070 SUPER(VRAM 8GB)のComfyUIでSDXLを、既定・--lowvram・fp8の3モード×解像度・枚数の12条件で実測。全条件でエラーなく完走した結果と、--lowvramで差が出なかった理由を公式情報で整理する。
VRAM 8GBでも、ComfyUI 0.37.0ならSDXLは2048×2048まで完走した。ただし --lowvram を付けても速さはほぼ変わらず、2048は「動く」と「使える絵」が別物だった。
前に画像生成AIに必要なVRAMの記事で、SDXLの目安を公式情報から整理した。今回はその答え合わせだ。
手元のRTX 2070 SUPER機(i7-9700K/メモリ16GB)で測った。条件は3モード×4ケースの12通りで、各1回。1台・1回の測定なので、環境が違えば結果は変わる。
測った条件。8GBの枠に6.94GBのモデルを入れる
SDXLのbaseモデル sd_xl_base_1.0.safetensors は、Hugging Face上で6.94GBと表示されている(出典: Stability AI SDXL base 1.0 ファイル一覧)。
RTX 2070 SUPERのメモリは公称8GB GDDR6、256-bit、アーキテクチャはTuringだ(出典: NVIDIA GeForce RTX 20シリーズ比較)。
現場でいえば、搬入口が8GBしかないのに、7GB近い資材を入れて作業するようなものだ。
| 項目 | 内容 |
|---|---|
| 測定日 | 2026年9月28日 |
| 機材 | i7-9700K / RTX 2070 SUPER(VRAM 8GB)/ DDR4 16GB / Windows 11 Home |
| ソフト | ComfyUI 0.37.0 / PyTorch 2.13.0+cu130 / NVIDIAドライバー 617.14 |
| モデル | sd_xl_base_1.0.safetensors(Stability AI公式) |
| 生成設定 | euler/normal・20ステップ・CFG 7.0。プロンプト固定、シードは測定ごとに変更 |
| モード | 既定(オプションなし)/ --lowvram / --fp8_e4m3fn-unet |
| ケース | 1024×1024を1枚・4枚、1536×1536を1枚、2048×2048を1枚 |
| 回数 | 各モードの最初にモデル読み込みを1回済ませ、その後の各条件を1回ずつ |
| 時間の取り方 | ComfyUIの実行開始→完了の時刻差(ログの Prompt executed in と一致) |
| VRAMの取り方 | nvidia-smiを約1秒ごとに読んだ最大値(画面表示分も含む) |
シードを毎回変えたのは、ComfyUIが同じ入力の結果を使い回して0秒で終わるのを避けるためだ。
結果。12条件すべてが完走、VRAM不足エラーは0件
数値をそのまま並べる。
| 条件 | 既定 | –lowvram | –fp8_e4m3fn-unet |
|---|---|---|---|
| 1024×1024・1枚 | 18.32秒(VRAM最大 7811MiB) | 17.97秒(7811MiB) | 14.94秒(7795MiB) |
| 1024×1024・4枚 | 56.82秒(7310MiB) | 57.96秒(7256MiB) | 59.2秒(7509MiB) |
| 1536×1536・1枚 | 45.92秒(7902MiB) | 45.14秒(7880MiB) | 43.78秒(7829MiB) |
| 2048×2048・1枚 | 135.82秒(7886MiB) | 135.89秒(7861MiB) | 144.57秒(7837MiB) |
| 参考: 読み込み込みの1回目(1024×1024・1枚) | 32.51秒 | 32.26秒 | 34.18秒 |
VRAMの最大値は、どの条件でも7.3〜7.9GBだった。8GBの枠をほぼ使い切っている。それでもエラーにはならなかった。
最初の1枚だけは、モデル読み込みのぶん30秒台かかった。2枚目からは1024×1024が20秒弱だ。
起動ログには Total VRAM 8192 MB, total RAM 16305 MB と出ており、GPUとメモリは正しく認識されていた。
生成の様子を録画したのが次の動画だ。
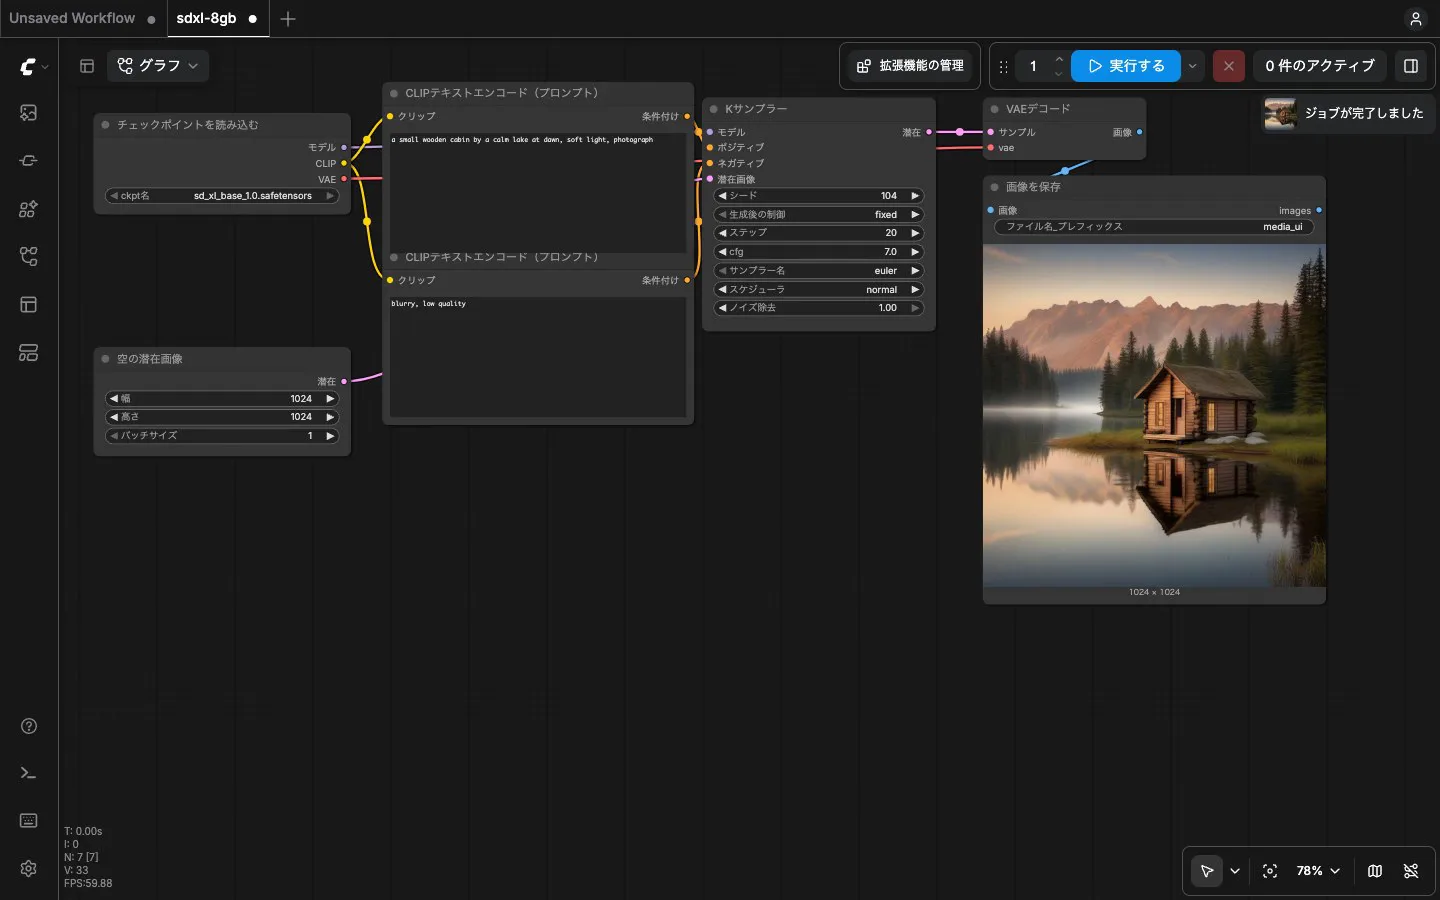
生成中のnvidia-smiはこうだった。開始から約16秒後の出力で、プロセス一覧はComfyUIの行だけ抜粋している。
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 617.14                 KMD Version: 617.14        CUDA UMD Version: 13.4     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                  Driver-Model | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 2070 ...  WDDM  |   00000000:01:00.0  On |                  N/A |
| 40%   76C    P2            210W /  215W |    6089MiB /   8192MiB |    100%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
消費電力は210W/215W、温度76℃、使用率100%。この瞬間のVRAMは6089MiBで、GPUは生成に使われ続けていた。
–lowvramで差が出なかった理由。公式の説明に書いてある
一番意外だったのは、--lowvram を付けても時間もVRAM最大値もほぼ同じだったことだ。
理由はComfyUI自身の引数説明に書いてあった。v0.37.0の --lowvram のヘルプは「dynamic vramが有効なら何もしない。dynamic vramを使っていない場合は、テキストエンコーダーをCPUで動かす」という趣旨だ(出典: ComfyUI v0.37.0 cli_args.py)。
手元の起動ログは、既定・--lowvram のどちらでも DynamicVRAM support detected and enabled と Using async weight offloading with 2 streams を出していた。つまり今回の条件では、--lowvram は効く場面そのものが無かったと読める。
関連する引数を公式の説明どおりに並べる(出典: ComfyUI v0.37.0 cli_args.py)。
| 引数 | 公式ヘルプの趣旨 |
|---|---|
--lowvram |
dynamic vram有効時は何もしない。無効時はテキストエンコーダーをCPUで実行 |
--novram |
lowvramで足りないとき用 |
--disable-dynamic-vram |
dynamic VRAMを切り、見積もりベースの読み込みにする |
--async-offload |
重みの非同期オフロード。ストリーム数の既定は2、NVIDIAでは既定で有効 |
--reserve-vram |
OSやほかのソフト用に残すVRAM量(GB)を指定 |
--fp8_e4m3fn-unet |
UNetの重みをfp8_e4m3fnで保持する |
dynamic VRAMを切った状態での比較は、今回していない。切れば --lowvram の効き方が変わる可能性はあるが、それは推測で、測っていない。
fp8は「速くなる設定」ではなかった。2070 SUPERの世代の話
fp8モードは、1024×1024・1枚で14.94秒と一番速かった。だが4枚では59.2秒、2048では144.57秒で、どちらも既定より遅い。各1回の測定なので、「fp8が速い」とは言えない。
公式ヘルプでも --fp8_e4m3fn-unet は「UNetの重みをfp8で保持する」指定だ(出典: ComfyUI v0.37.0 cli_args.py)。計算方法を変える指定ではない。
手元のログにも model weight dtype torch.float8_e4m3fn, manual cast: torch.float16 と出ていた。重みはfp8で持ち、計算はfp16に戻している。
そもそもNVIDIAのTransformer Engineは、FP8に対応するGPUとしてHopper・Ada・Blackwell・Rubinを挙げている(出典: NVIDIA Transformer Engine)。2070 SUPERのTuringは入っていない。重みをfp8で持っても、計算自体が速くなる世代ではない、ということだ。
VRAM最大値もfp8で大きく下がってはいなかった。8GBの枠いっぱいまで使う動き方は、3モードとも同じだった。
解像度と枚数。2048は完走したが、絵が崩れた
時間を大きく動かしたのは、モードではなく解像度だ。既定モードで1536は45.92秒、2048は135.82秒。画素数が約1.8倍で、時間は約3倍になった。
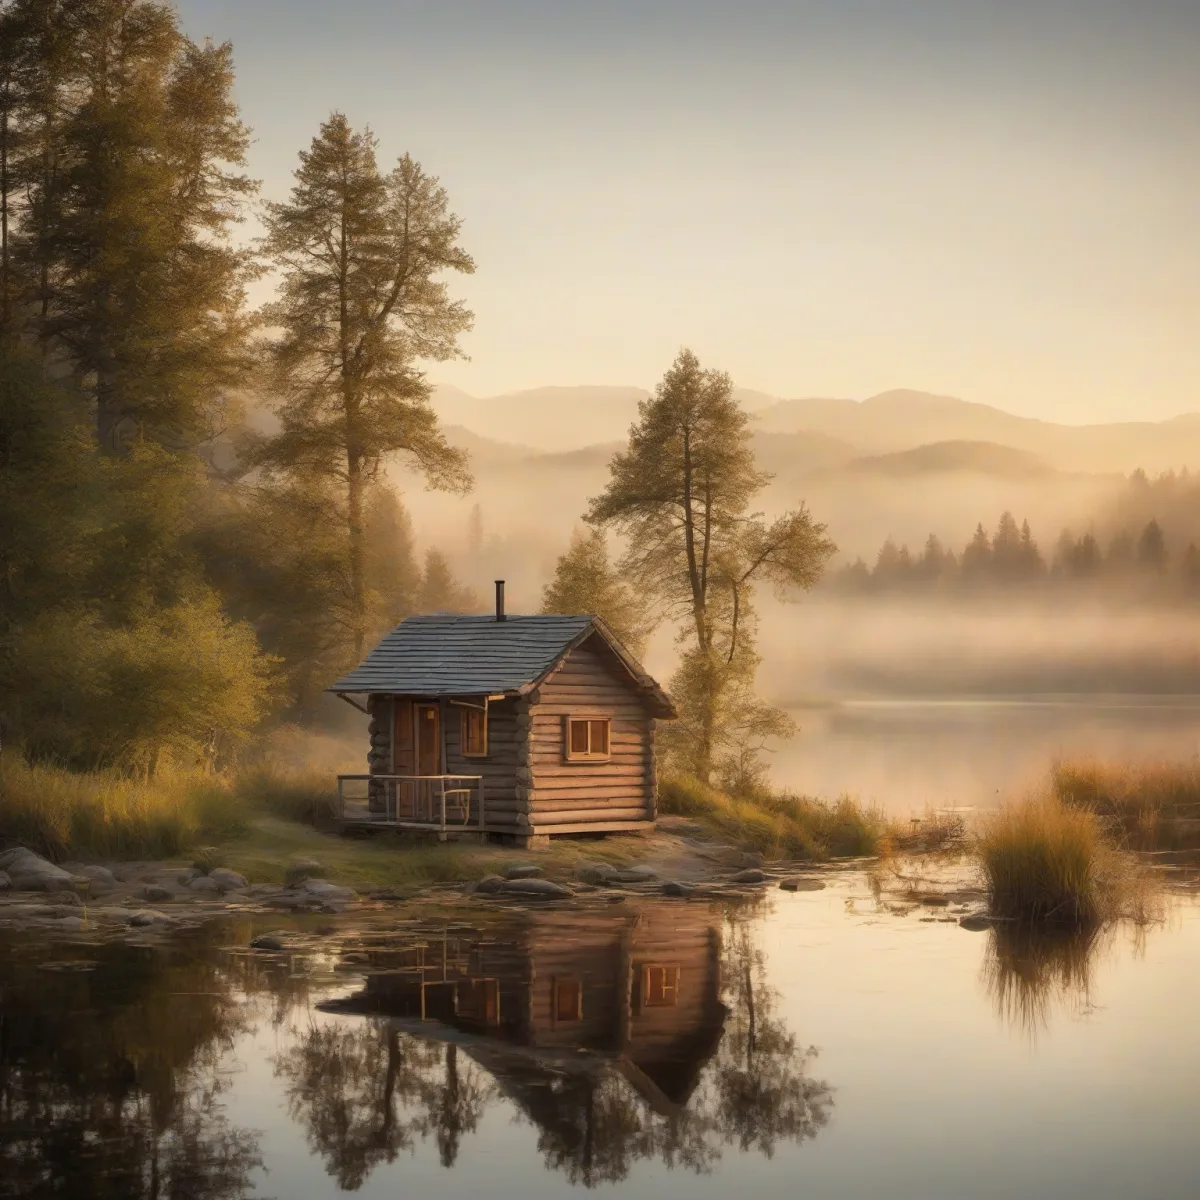
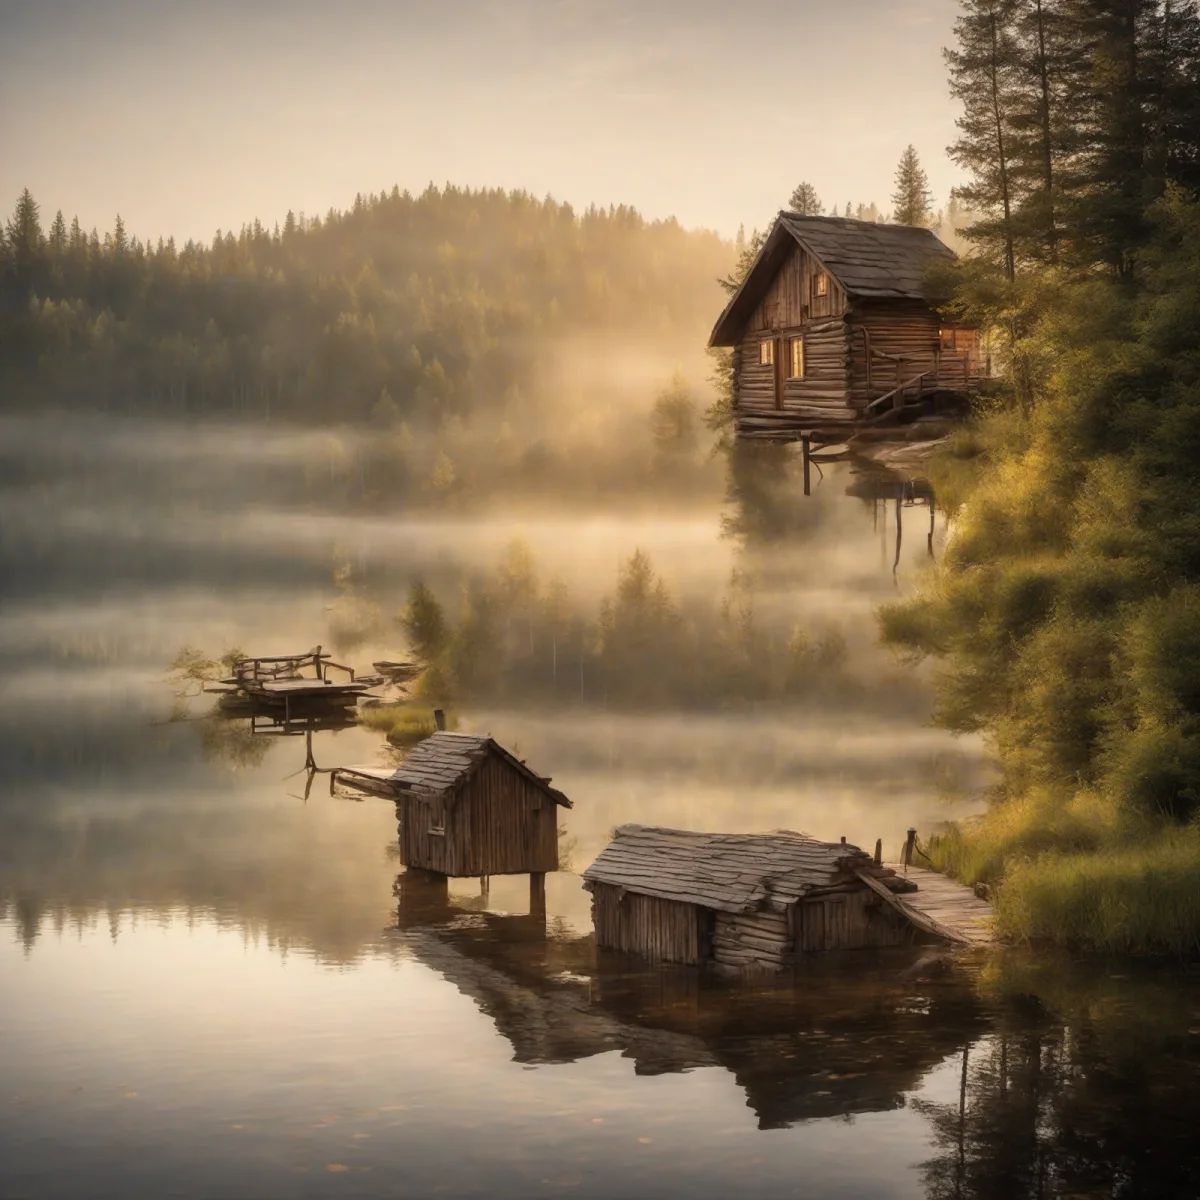
公式情報も1024前後を基準にしている。ComfyUIのSDXL例は「最適な結果には1024×1024か、同じ画素数で縦横比の違う解像度を」としている(出典: ComfyUI Examples SDXL)。Diffusersのドキュメントも、SDXLは既定で1024×1024を生成するとしている(出典: Hugging Face Diffusers SDXL)。
つまり8GBで2048が「動く」のは確かめられたが、そのまま使える絵が出るとは限らない。大きい絵が欲しいなら、1024前後で作ってから拡大する段取りのほうが筋がいい。段取り八分だ。
枚数のほうは、1024×1024を4枚まとめて56.82秒だった。1枚の18.32秒を4回分(73.28秒)と比べると短い。ただし各1回の測定で、まとめ生成が常に速いとまでは言えない。
AUTOMATIC1111の –medvram-sdxl と、今回やっていないこと
検索でよく並ぶ --medvram-sdxl は、AUTOMATIC1111(stable-diffusion-webui)の引数だ。公式Wikiでは「SDXLモデルのときだけ --medvram の最適化を有効にする」とされる。--medvram は「多少の速度と引き換えにVRAM使用量を減らす」、--lowvram は「大きく速度を犠牲にして、VRAM使用量をかなり減らす」と説明されている(出典: AUTOMATIC1111 Wiki Command Line Arguments)。
今回はComfyUIだけで測っており、A1111では測っていない。同じ --lowvram という名前でも、ソフトが違えば中身は別物だ。
ほかに、次の点は検証していない。
- FLUX(モデル未導入)
- dynamic VRAMを切った比較、
--novram・--highvram - 同じ条件の繰り返し測定(ばらつき)
- refinerを使ったSDXLの2段構成
まとめ。8GBでSDXLをやるなら
測った範囲で言えるのは次の3つだ。
- ComfyUI 0.37.0なら、VRAM 8GBでSDXLは2048×2048まで完走した(12条件でエラー0件)
- dynamic VRAMが有効な状態では、
--lowvramは公式説明どおり差を生まなかった - fp8指定はTuring世代では安定して速くならず、2048は絵が崩れた。1024前後で作るのが基準
8GBは「動かない」枠ではなかった。ただ、VRAMは毎回ほぼ上限まで埋まっていて、余裕はない。LoRAやControlNetを重ねる、動画に手を広げるなら、枠を広げる話になる。VRAM別の選び方はRTX 5060と5070のVRAM比較、ComfyUIの入れ方はComfyUI導入手順にまとめてある。
買い替えを考えるなら、今週のセール機をVRAM基準で仕分けた表と二刀流ランキングを置いておく。最強の1台より、VRAMの枠と解像度の基準、この2点を外さない1台だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機・1台・2026年9月28日)での測定に基づく解説です。各条件1回の測定で、ドライバー・ComfyUIの版・設定・画面表示の有無で結果は変わります。FLUX、AUTOMATIC1111、dynamic VRAM無効時の挙動は検証していません。最新の仕様は各公式ドキュメントをご確認ください。
出典
- Stability AI SDXL base 1.0 モデルカード(Latent Diffusion Model、2つのテキストエンコーダー、enable_model_cpu_offload): https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
- Stability AI SDXL base 1.0 ファイル一覧(sd_xl_base_1.0.safetensors 6.94GB): https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/tree/main
- ComfyUI v0.37.0 cli_args.py(–lowvram・–novram・–disable-dynamic-vram・–async-offload・–reserve-vram・–fp8_e4m3fn-unet のヘルプ): https://github.com/comfyanonymous/ComfyUI/blob/v0.37.0/comfy/cli_args.py
- ComfyUI Examples SDXL(1024×1024か同じ画素数の解像度を推奨): https://comfyanonymous.github.io/ComfyUI_examples/sdxl/
- Hugging Face Diffusers SDXL(既定で1024×1024を生成、メモリ節約のCPUオフロード): https://huggingface.co/docs/diffusers/main/en/using-diffusers/sdxl
- SDXL論文(UNetが従来の3倍、複数の縦横比で学習): https://arxiv.org/abs/2307.01952
- AUTOMATIC1111 Wiki Command Line Arguments(–medvram・–medvram-sdxl・–lowvram): https://github.com/AUTOMATIC1111/stable-diffusion-webui/wiki/Command-Line-Arguments-and-Settings
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER 8GB GDDR6・256-bit・Turing・215W): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- NVIDIA Transformer Engine(FP8対応: Hopper・Ada・Blackwell・Rubin): https://github.com/NVIDIA/TransformerEngine