RTX 2070 SUPERの消費電力をnvidia-smiで実測 — SDXL生成・ローカルLLM・アイドルでGPUは何W使うか
RTX 2070 SUPER機のGPUボード電力をnvidia-smiで0.5秒ごとに記録。アイドル46.8W、SDXLは1枚0.906Wh、qwen3 8B生成は平均193.0W、VRAMからあふれた14Bは61.0Wだった。31円/kWhでGPU分の電気代も出す。
RTX 2070 SUPERのGPUボード電力をnvidia-smiで0.5秒ごとに記録した。SDXLは1枚あたり0.906Wh、qwen3 8Bの生成中は平均193.0W、VRAMからあふれたqwen3 14Bは平均61.0Wだった。公称215Wに張り付くのは、思ったより短い。
前にAI生成の電気代の目安で、公称電力×時間×単価で「天井」を出す計算式を書いた。あの記事は公称値だけで組み、実測値は入れていない。
今回はその中身を、手元のRTX 2070 SUPER機(i7-9700K/メモリ16GB)で測った。1台・1回の通し測定なので、環境が違えば結果は変わる。
最初に線を引いておく。測ったのはnvidia-smiが返すGPUボードの電力だけで、PC全体(コンセント側)の電力ではない。 CPU・メモリ・ファン・電源ユニットの損失は入っていない。コンセント側は電力計を用意してから別に測る。
測った条件。約24分を0.5秒刻みで記録した
Windows機の上でnvidia-smiを0.5秒ごとのループで走らせ、記録を止めずに、アイドル→SDXL→ローカルLLM→アイドルと段階を進めた。
| 項目 | 内容 |
|---|---|
| 測定日 | 2026年10月31日(約24分・1回の通し) |
| 機材 | パソコン工房 LEVEL∞(i7-9700K / RTX 2070 SUPER 8GB / DDR4 16GB / Windows 11 Home) |
| ドライバー | NVIDIA 617.14。電力上限は既定の215W(測定中ずっと同じ) |
| 記録 | nvidia-smi --query-gpu=…,power.draw,… -lms 500。2,782点、実際の間隔は中央値513ms |
| 画像生成 | ComfyUI 0.37.0(起動オプションなし)、SDXL base 1.0、1024×1024・20ステップ・CFG 7.0・euler/normal。1枚ずつ10枚 |
| ローカルLLM | Ollama 0.34.4、qwen3 8B/14B(q4_K_M)、temperature 0・think=false。8Bは1024トークン×5回、14Bは384トークン×3回 |
| 電力量 | 区間内の power.draw を時間で積み上げた値(Wh) |
| 画面 | 普段の常駐アプリを起動したまま、144Hzのディスプレイ1台を表示中 |
時刻はWindows機の時計で記録した。SDXLの1枚ごとの区間は、ComfyUIが記録する実行開始と完了の時刻をそのまま使っている。
結果。段階ごとに見るとGPUの電力は4段に分かれた
棒の長さで見ると、アイドルとモデルを読み込んだままの待機は47〜50W、14Bの生成が61W、SDXLが141.8W、8Bが193.0Wだった。
| 段階 | 時間 | 平均 | 中央値 | 最大 | 電力量 |
|---|---|---|---|---|---|
| アイドル(サーバー未起動) | 120.0秒 | 46.8W | 46.8W | 47.4W | 1.559Wh |
| SDXL 1024×1024 連続10枚 | 231.5秒 | 141.8W | 183.1W | 227.8W | 9.128Wh |
| SDXLを読み込んだまま待機 | 60.0秒 | 48.8W | 48.1W | 68.8W | 0.813Wh |
| qwen3 8B 生成5回 | 79.2秒 | 193.0W | 193.5W | 219.6W | 4.247Wh |
| qwen3 8B を読み込んだまま待機 | 60.0秒 | 49.7W | 48.8W | 75.7W | 0.833Wh |
| qwen3 14B 生成3回 | 151.2秒 | 61.0W | 65.2W | 66.3W | 2.562Wh |
| アイドル(全停止後) | 60.0秒 | 47.4W | 47.4W | 47.9W | 0.79Wh |
約24分の全体では、平均75.7W・30.139Whだった。
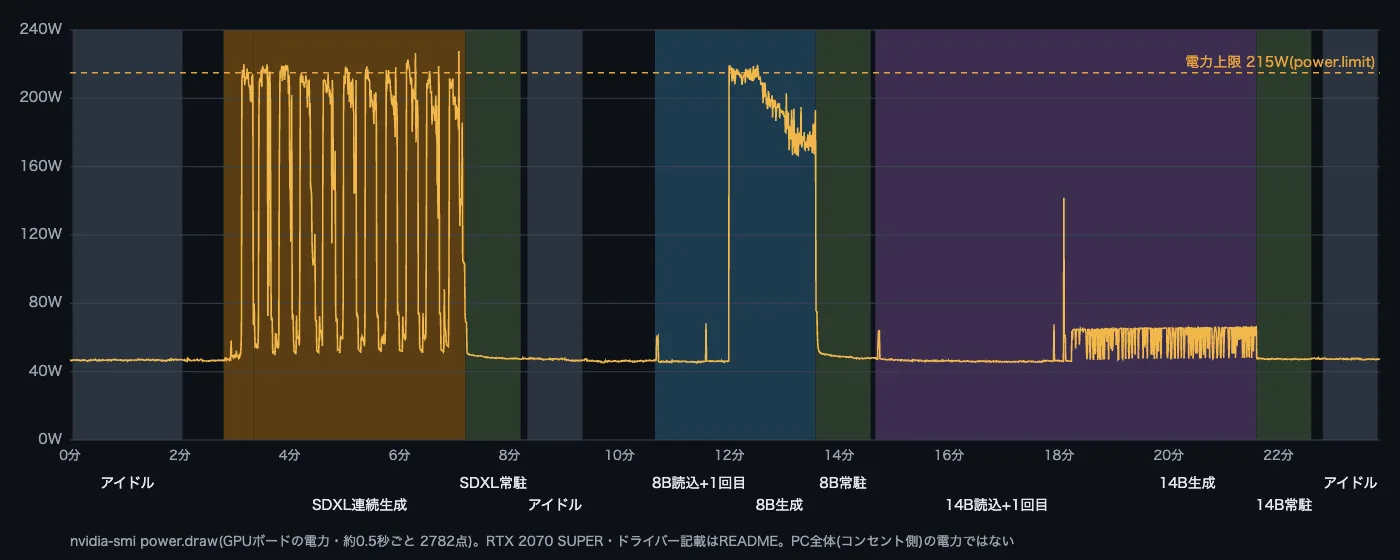
モデルをVRAMに読み込んだまま待っている間は、アイドルとほぼ変わらなかった。読み込んでおくだけなら、電気はほとんど増えないということだ。
一方で、アイドルそのものが46.8Wと低くない。この機械はアイドル中もP0(最高性能の状態)のまま、グラフィックス1605MHz・メモリ7000MHzに張り付いていた。常駐アプリや144Hz表示の影響かは切り分けていない。
SDXLは1枚0.906Wh。全力で回るのは生成時間の半分ほど
10枚の1枚あたりは、実行時間の中央値が22.39秒、GPUボードの電力量が平均0.906Wh(0.833〜1.018Wh)だった。
グラフのSDXLの帯は、200W超と50W台を往復している。実行中のサンプルで150Wを超えていたのは52.7%だった。1枚の中でも、ずっと上限近くで回っているわけではない。
1枚の始まりと終わりぎわのnvidia-smiの記録を抜き出すとこうなる(改変なし)。
timestamp, power.draw [W], power.limit [W], enforced.power.limit [W], utilization.gpu [%], memory.used [MiB], temperature.gpu, clocks.current.graphics [MHz], clocks.current.sm [MHz], clocks.current.memory [MHz], pstate, fan.speed [%]
# SDXL 1024×1024 生成中(2枚目の実行開始から約5秒後)
2026/10/31 22:39:08.932, 61.67, 215.00, 215.00, 12, 6524, 63, 1605, 1605, 6801, P2, 41
2026/10/31 22:39:09.443, 61.46, 215.00, 215.00, 18, 6652, 62, 1605, 1605, 6801, P2, 41
# SDXL 同じ1枚の終わりぎわ(実行完了の約3秒前)
2026/10/31 22:39:23.567, 210.54, 215.00, 215.00, 98, 7932, 83, 1830, 1830, 6801, P2, 47
2026/10/31 22:39:24.082, 147.59, 215.00, 215.00, 98, 6940, 78, 1875, 1875, 6801, P2, 47
冒頭の数秒は60W前後・使用率10%台で、VRAMの使用量が増えていく途中だ。ComfyUIのログには毎回 Model SDXL prepared for dynamic VRAM loading. 4896MB Staged. が出ていたので、この低い区間はモデルの準備にあたると考えている(推測。区間の内訳は測っていない)。
なお、9月に同じ条件で測った1枚は18.32秒だった(VRAM 8GBでSDXLはどこまで動くか)。今回は2枚目以降が21.74〜28.03秒で、遅くなった理由は切り分けていない。
ローカルLLM。8Bは上限近く、あふれた14Bは61W
qwen3 8Bは、5.58GBがすべてVRAMに載った。生成中のGPU使用率は約96%で、平均193.0W。1000トークンあたりのGPU電力量は中央値0.825Whだった。
ただ、5回続けるうちに電力が下がっていった。
| 回 | 速度 | 平均電力 | 平均温度 | クロック平均 |
|---|---|---|---|---|
| 1回目 | 66.04 tok/s | 213.8W | 78.8℃ | 1831.5MHz |
| 3回目 | 65.08 tok/s | 192.8W | 84.5℃ | 1731.0MHz |
| 5回目 | 63.77 tok/s | 176.0W | 86.0℃ | 1643.0MHz |
温度が上がるにつれてクロックと電力が下がり、速度も少し落ちた。温度による制御と考えられるが、クロックが下がった理由そのものは記録していない(推測)。重機も、真夏の連続運転では同じ出力を出し続けられない。
qwen3 14Bは、10.15GBのうちVRAMに載ったのは6.35GBで、残りはCPU側に回った。このあふれ方はVRAMからあふれたときのOllamaの実測で書いたとおりだ。
生成中のGPU使用率は13%前後、電力は平均61.0Wで、クロックは1605MHzから上がらなかった。GPUがCPU側の計算を待っている状態と読める。
ここで勘違いしやすい点がある。GPUの電力が低いから省エネ、ではない。1000トークンあたりのGPU電力量は中央値2.224Whで、8Bの約2.7倍だった。しかもこれはGPU分だけで、CPU側で計算している分の電力は入っていない。PC全体で比べれば、差はもっと開くはずだ(推測・未測定)。
電気代に直すと。GPU分だけで1枚約0.028円
AI生成の電気代の目安と同じ式、W÷1000×時間×単価で計算する。単価もあの記事と同じ、家電公取協の目安単価31円/kWhを使った。どれもGPUボード分だけの金額で、PC全体の電気代ではない。
| 項目 | GPUボードの電力量 | 金額(31円/kWh) |
|---|---|---|
| SDXL 1枚(1024×1024・20ステップ) | 0.906Wh | 約0.028円(1kWhで約1,104枚) |
| qwen3 8B 1000トークン | 0.825Wh | 約0.026円 |
| qwen3 14B 1000トークン | 2.224Wh | 約0.069円 |
| アイドルが1時間 | 平均46.8W | 約1.45円 |
| SDXL連続生成が1時間 | 平均141.8W | 約4.4円 |
| qwen3 8B 生成が1時間 | 平均193.0W | 約5.98円 |
| 参考: 公称215Wを1時間 | 215W | 6.665円 |
公称値で出した天井(6.665円)に対して、8Bの連続生成はその9割ほど、SDXLは7割弱だった。天井で予算を組んでおけば外れない、という前の記事の読み方は、この1台では当たっていた。
逆に、つけっぱなしのアイドルも1時間約1.45円かかる。生成していない時間が長い使い方なら、こちらのほうが効いてくる。
nvidia-smiの数字を読むときの注意
nvidia-smi 617.14 のヘルプによると、power.draw はボード全体の電力で、Ampere以降は1秒平均、それより古い世代は瞬時値、精度は±5Wとされる。RTX 2070 SUPERはTuring世代なので瞬時値だ。nvidia-smi -q -d POWER でも平均電力の欄は N/A だった。
瞬時値なので、上限215Wを超える読み(最大227.8W)も出た。上限は電力管理が平均として抑える値なので、瞬間的な読みが超えることはありうる(解釈。詳しい挙動は確かめていない)。
それから、ボードの電力はコンセントの電力ではない。NVIDIAの公式仕様でも、RTX 2070 SUPERのグラフィックスカード電力は215W、PC全体の最小システム電力は650Wと別の数字で書かれている。表示の読み方はnvidia-smiでGPUの使用状況を確かめる方法にまとめてある。
まとめ。電力は「何をさせているか」で4段に分かれる
測った範囲で言えるのは次の3つだ。
- アイドルとモデル常駐は47〜50W。読み込んでおくだけなら電気はほぼ増えない
- SDXLは1枚0.906Wh、8Bの生成は平均193.0W。上限に張り付く時間は思ったより短い
- VRAMからあふれた14BはGPUが61Wで待つだけになり、1000トークンあたりでは8Bの約2.7倍かかった
電気代を下げたいなら、まずVRAMに収まるモデルを選ぶこと。段取り八分で、搬入口に入る資材を選べば重機は止まらない。
本体を選ぶ段階なら、今週のセール機をVRAM基準で仕分けた表と、ゲームとAIの両方を基準にした二刀流ランキングを置いておく。最強の1台より、VRAMの枠と電源の余裕、この2点を外さない1台だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機・1台・2026年10月31日)での測定に基づく解説です。数値はnvidia-smiが返すGPUボードの電力で、PC全体(コンセント側)の消費電力ではありません。1回の通し測定で、常駐アプリ・室温・ドライバー・設定が違えば結果は変わります。電気代は目安単価31円/kWhでの計算値で、実際の金額は契約内容によって変わります。
出典
- NVIDIA System Management Interface(nvidia-smi)documentation(Power Draw はボード全体の電力、Average はAmpere以降、Performance State P0〜P12): https://docs.nvidia.com/deploy/nvidia-smi/index.html
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER: グラフィックスカード電力215W、最小システム電力650W、8GB GDDR6): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- 全国家庭電気製品公正取引協議会 よくある質問(電力料金の目安単価31円/kWh): https://www.eftc.or.jp/qa/
- Ollama API documentation(eval_count・eval_duration・load_duration・keep_alive): https://github.com/ollama/ollama/blob/main/docs/api.md
- Stability AI SDXL base 1.0 モデルカード: https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
- ComfyUI v0.37.0(DynamicVRAM・起動オプション): https://github.com/comfyanonymous/ComfyUI/blob/v0.37.0/comfy/cli_args.py